De toutes les ressources d’une page, le JavaScript est la plus coûteuse. Une image de 200 kilo-octets, une fois téléchargée, n’a plus qu’à être décodée et affichée. Un script de 200 kilo-octets doit être téléchargé, puis analysé, compilé et exécuté sur le thread principal, celui-là même qui doit répondre aux touches et aux clics de l’utilisateur. Sur un smartphone de milieu de gamme, ce travail peut prendre des centaines de millisecondes, avec des effets directs sur l’INP et, souvent, sur le LCP aussi.
Les outils utilisés aujourd’hui pour construire le JavaScript d’un site offrent des techniques efficaces pour en réduire le coût : découper le code en morceaux chargés seulement quand c’est nécessaire, supprimer automatiquement les parties inutilisées, éviter de traduire du code pour des navigateurs que plus personne n’utilise. Ce sont des concepts souvent enveloppés d’un jargon technique, bundle, chunk, tree shaking, qui décourage quiconque n’écrit pas de code tous les jours. Dans cet article, nous les expliquons simplement, avec des exemples concrets, à l’intention de ceux qui doivent comprendre ce qu’il faut demander à un développeur ou évaluer le travail d’un prestataire.
Du code source au bundle
Le JavaScript d’un site moderne n’est pas écrit dans un seul fichier. Il est divisé en modules : un pour le menu, un pour la galerie, un pour le panier, plus les bibliothèques tierces sur lesquelles il s’appuie. Avant d’être publié, un outil appelé bundler, comme Vite, webpack, esbuild ou Rollup, rassemble tous ces modules, résout les dépendances entre eux et produit un ou plusieurs fichiers optimisés pour le navigateur, appelés bundles. À cette étape, il peut aussi minifier le code, c’est-à-dire supprimer les espaces et les commentaires et raccourcir les noms, et l’adapter aux navigateurs visés.
La configuration la plus simple produit un seul bundle avec tout le code du site, chargé sur chaque page. C’est pratique, mais chaque page paie le coût de toutes les fonctionnalités, y compris de celles qu’elle n’utilise pas : la page d’accueil télécharge le code du tunnel de commande, l’article de blog celui de la galerie de produits. À mesure que le site grandit, le bundle grandit avec lui.
Code splitting : ne charger que le nécessaire
Le code splitting résout le problème en produisant plusieurs bundles au lieu d’un seul. Un bundle de base contient ce qui est nécessaire partout, comme le menu et les fonctions communes ; les autres bundles, appelés chunks, contiennent des fonctionnalités spécifiques et ne sont chargés que sur les pages ou aux moments où ils sont nécessaires.
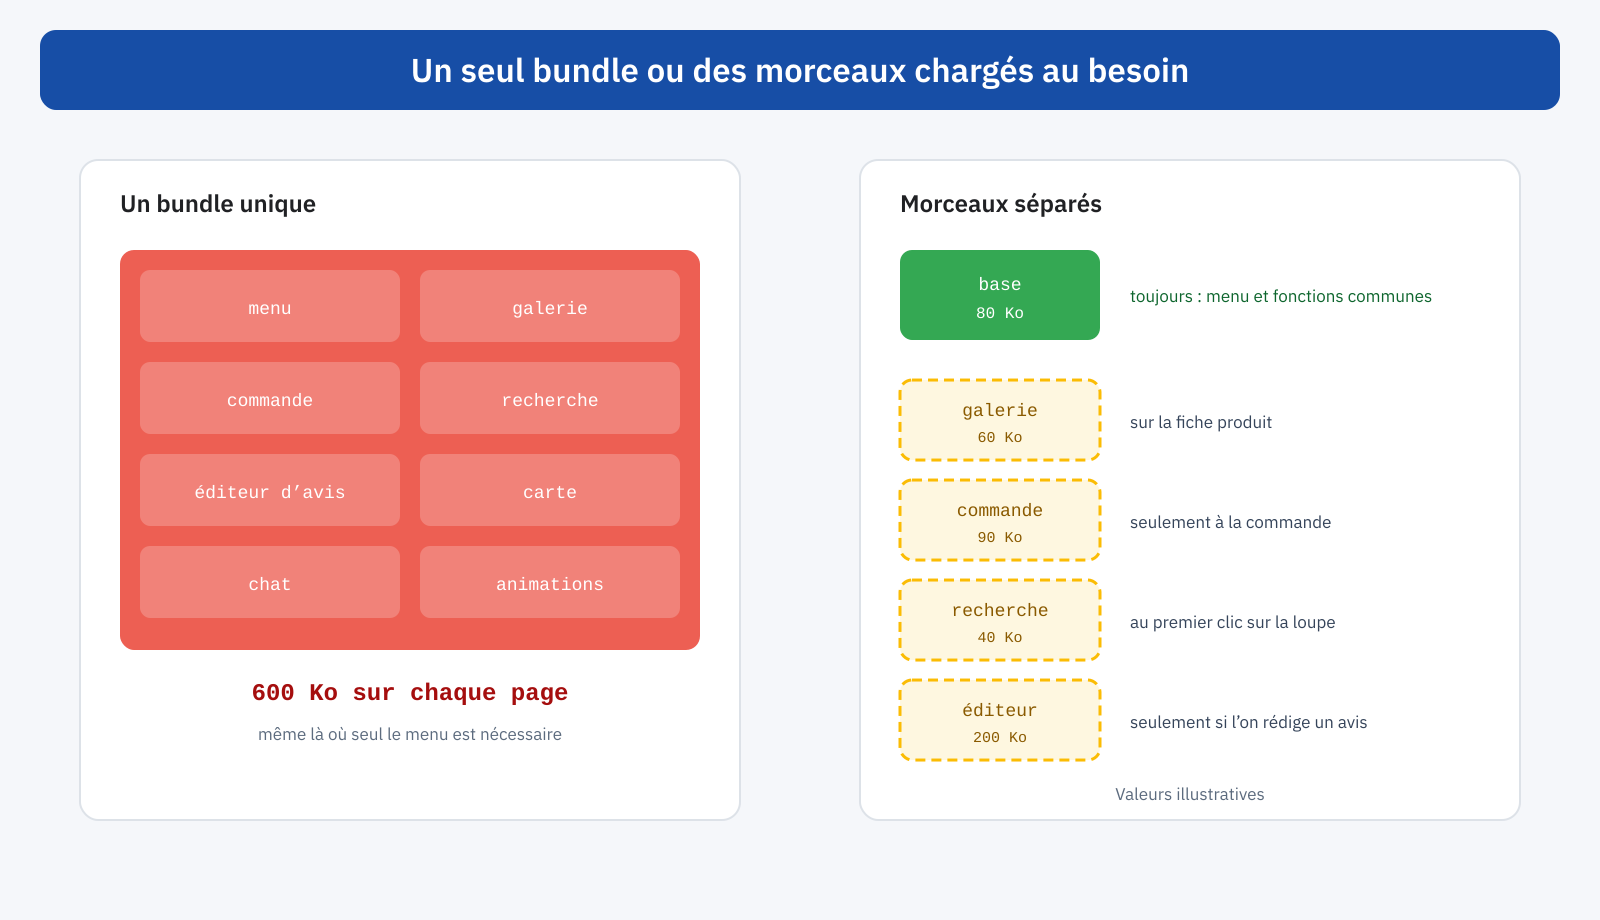
Le découpage peut suivre deux critères. Par page, ou par route : chaque type de page a son propre bundle, et la fiche produit ne charge pas le code du tunnel de commande. Par fonctionnalité : les parties qui ne sont nécessaires qu’après une action de l’utilisateur, comme l’éditeur pour rédiger un avis, la visionneuse d’images en plein écran ou la recherche avec suggestions, ne sont chargées que lorsque l’utilisateur s’en sert. L’outil pour cela est l’import dynamique, une fonctionnalité du langage qui charge un module au moment du besoin :
const pulsante = document.querySelector( '.apri-galleria' );

pulsante.addEventListener( 'click', async () => {
	// Le code de la galerie n’est téléchargé qu’au premier clic
	const { apriGalleria } = await import( './galleria.js' );
	apriGalleria( pulsante.dataset.prodotto );
} );
Le bundler reconnaît import() et produit automatiquement un bundle séparé pour galleria.js et ses dépendances. Le premier clic demande un court téléchargement, qui peut être avancé quand l’utilisateur approche du bouton ou avec un modulepreload, comme l’explique l’article sur preload, preconnect et fetchpriority ; en revanche, tous les utilisateurs qui n’ouvrent pas la galerie ne paient rien.
Le découpage doit se faire avec modération. Trop de petits morceaux multiplient les requêtes et peuvent créer des chaînes, dans lesquelles un morceau ne découvre le suivant qu’après avoir été exécuté. Une bonne règle est de séparer ce qui est gros et utilisé par peu de gens, et de garder ensemble ce qui est petit et utilisé par beaucoup.
Tree shaking : retirer ce qui n’est pas utilisé
Le deuxième concept concerne les bibliothèques. Une bibliothèque utilitaire peut offrir des dizaines de fonctions, et un site en utilise peut-être trois. Si le code importe toute la bibliothèque, le bundle la contient en entier. Le tree shaking est la capacité du bundler à analyser quelles fonctions sont réellement importées et utilisées et à retirer toutes les autres, comme des feuilles mortes qui tombent d’un arbre.
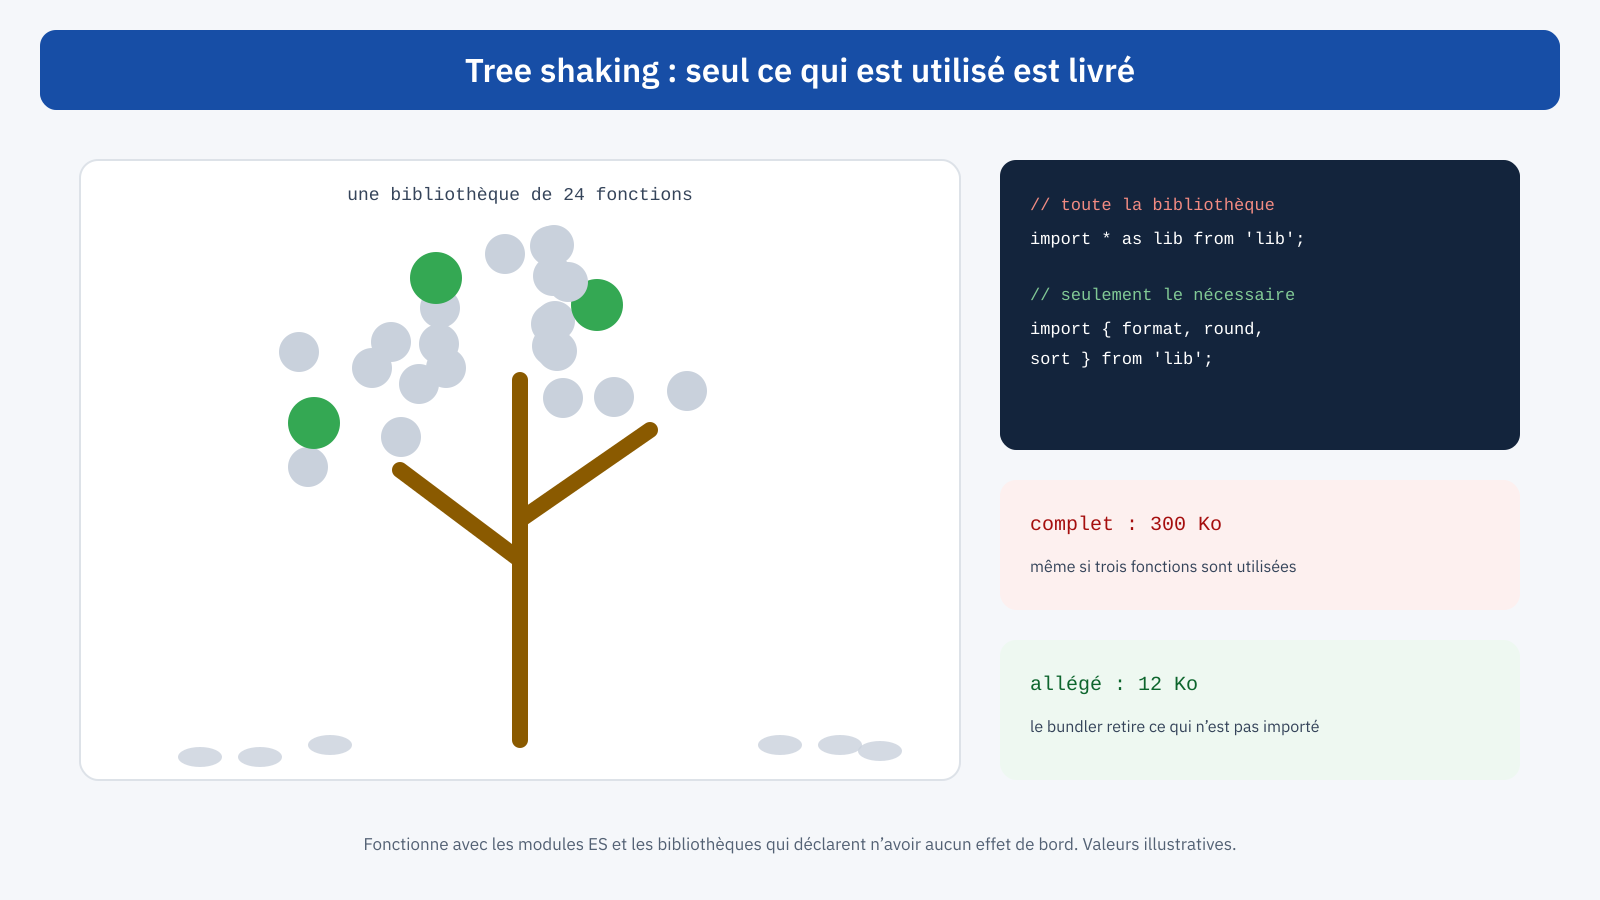
Deux conditions sont nécessaires pour que cela fonctionne. La première est que le code utilise les modules standard de JavaScript, avec des instructions import et export que le bundler peut analyser avant l’exécution ; les bibliothèques écrites avec d’anciens systèmes de modules ne se prêtent pas à cette analyse. La seconde est que la bibliothèque déclare n’avoir aucun effet de bord, c’est-à-dire que l’importation d’un morceau n’exécute pas de code nécessaire ailleurs. Les bibliothèques modernes sont généralement conçues pour cela ; pour les plus anciennes, il existe souvent des versions alternatives ou des paquets séparés par fonction.
// Importe toute la bibliothèque : le bundle la contient en entier
import _ from 'lodash';
_.debounce( aggiorna, 200 );

// Importe seulement la fonction utilisée : le reste est retiré
import { debounce } from 'lodash-es';
debounce( aggiorna, 200 );
Un piège fréquent, ce sont les fichiers qui réexportent tout depuis un point unique, pratiques pour celui qui écrit le code mais capables, dans certaines configurations, d’entraîner dans le bundle beaucoup plus que nécessaire. Pour le savoir, il faut regarder ce qui se retrouve vraiment dans le bundle, avec les outils d’analyse décrits plus bas.
Écrire pour les navigateurs d’aujourd’hui
Pendant des années, le JavaScript a été traduit, au moment de la compilation, vers une version compatible avec de très vieux navigateurs, et accompagné de polyfills, c’est-à-dire de code qui reproduit des fonctionnalités manquantes. Le résultat était un code plus volumineux et plus lent à exécuter, même pour ceux qui utilisent un navigateur moderne. Aujourd’hui, les navigateurs en usage prennent en charge presque toutes les fonctionnalités modernes du langage, et configurer le bundler pour les navigateurs que les visiteurs utilisent réellement, plutôt que pour ceux d’il y a dix ans, réduit le poids des bundles sans effet pour les utilisateurs. Les données d’analytics sur les navigateurs des visiteurs sont la base de ce choix.
Les dépendances : le poids qu’on ne voit pas
Dans de nombreux projets, la plus grande partie du JavaScript n’est pas le code écrit par les développeurs, mais celui des bibliothèques sur lesquelles il s’appuie. Une bibliothèque de dates, une d’animation, une de carrousel, un framework d’interface : chacune ajoute des dizaines ou des centaines de kilo-octets. Avant d’ajouter une dépendance, il vaut la peine de se demander si le navigateur offre déjà la fonctionnalité : formater les dates et les nombres avec les API d’internationalisation, les animations avec le CSS, la sélection d’éléments et les requêtes réseau avec les fonctions natives, qui ont rendu une grande partie de jQuery inutile. Des services en ligne permettent de connaître à l’avance le poids d’une bibliothèque et de ses alternatives.
Comment voir ce qu’il y a dans le bundle
La première étape de toute optimisation est de savoir ce que l’on charge. Les outils d’analyse de bundle, disponibles pour tous les principaux bundlers, produisent une carte visuelle dans laquelle chaque module est un rectangle proportionnel à son poids : d’un coup d’œil, on voit quelle bibliothèque occupe la moitié du bundle, quel module apparaît deux fois, quel code se retrouve sur des pages qui ne l’utilisent pas.
Dans le navigateur, le panneau Couverture de Chrome DevTools montre, pour chaque fichier JavaScript, la part qui a réellement été exécutée pendant le chargement et l’utilisation de la page. Un pourcentage élevé de code inutilisé ne signifie pas qu’il faut le supprimer, car une partie est nécessaire à des moments ultérieurs, mais il indique où le code splitting pourrait être plus efficace. Lighthouse signale une indication similaire avec la suggestion de réduire le JavaScript inutilisé.
Le cas de WordPress
Dans WordPress, le JavaScript provient de plusieurs sources : le thème, les plugins, le cœur. Les outils de développement officiels, comme le paquet scripts pour les blocs, utilisent un bundler moderne et produisent des bundles séparés pour chaque bloc. Depuis la version 6.5, WordPress prend aussi en charge les modules JavaScript natifs, avec sa propre interface pour les enregistrer et les charger, et les blocs peuvent déclarer des scripts à charger côté public seulement quand le bloc est présent sur la page, comme nous l’avons vu en parlant des thèmes de blocs.
Pour le code des thèmes et des plugins développés sur mesure, la règle la plus simple est de charger chaque script seulement là où il est nécessaire, avec des conditions dans l’enregistrement du script, au lieu de l’inclure sur toutes les pages. Pour les plugins tiers, le contrôle est plus limité, mais les outils de gestion des scripts permettent de les désactiver sur les pages où ils ne sont pas utilisés. Et pour les scripts qui ne sont pas nécessaires au premier chargement, le report jusqu’à la première interaction, décrit dans l’article sur le report du JavaScript, est l’équivalent d’un import dynamique appliqué de l’extérieur.
// Le carrousel du thème seulement sur les pages qui le contiennent
add_action(
	'wp_enqueue_scripts',
	function () {
		if ( is_singular() && has_block( 'tema/carosello' ) ) {
			wp_enqueue_script_module( 'tema-carosello', get_theme_file_uri( 'js/carosello.js' ) );
		}
	}
);
Un exemple
Une boutique en ligne avec un thème développé sur mesure charge sur chaque page un seul fichier JavaScript de 540 kilo-octets compressés. L’analyse du bundle montre qu’un tiers est occupé par une bibliothèque de dates, utilisée seulement pour afficher les délais de livraison, et par une bibliothèque d’animation complète, utilisée pour deux effets sur la page d’accueil ; un autre tiers est le code du configurateur de produit et du tunnel de commande, présent aussi dans les articles de blog. Il y a quatre correctifs : les dates sont formatées avec les API natives du navigateur, les deux animations sont réécrites en CSS, le configurateur et le tunnel de commande deviennent des bundles séparés chargés seulement sur leurs pages, et la visionneuse d’images en plein écran est chargée avec un import dynamique au premier clic sur une photo. Le bundle de base tombe à 110 kilo-octets ; la fiche produit charge 220 kilo-octets au total au lieu de 540. Le temps d’exécution des scripts au chargement baisse de plus de moitié sur les smartphones de milieu de gamme, et l’INP des fiches produit dans les données de terrain passe à l’état bon.
Ce qu’il faut demander à celui qui développe
Pour ceux qui n’écrivent pas de code mais doivent évaluer un projet, quelques questions aident à comprendre si le JavaScript est traité avec soin. Combien de JavaScript, compressé, chaque modèle de page charge-t-il ? Le code est-il découpé par page et par fonctionnalité, ou y a-t-il un seul bundle ? Quelles sont les trois dépendances les plus lourdes, et sont-elles vraiment nécessaires ? Pour quels navigateurs le code est-il compilé ? Y a-t-il un budget de performance sur le poids du JavaScript, vérifié à chaque livraison ? Les réponses en disent bien plus qu’un score.
En résumé
Le JavaScript est la ressource la plus coûteuse d’une page, parce qu’il doit s’exécuter sur le même thread que celui qui répond à l’utilisateur. Les bundlers modernes offrent trois leviers principaux pour en réduire le coût : le code splitting, qui ne charge chaque morceau que sur les pages et aux moments où il est nécessaire, avec des imports dynamiques ; le tree shaking, qui retire les fonctions inutilisées des bibliothèques ; et la compilation pour les navigateurs d’aujourd’hui, qui évite les traductions et les polyfills inutiles.
À cela s’ajoutent le choix attentif des dépendances, l’analyse périodique du contenu des bundles et, dans WordPress, le chargement des scripts seulement là où ils sont nécessaires. Il n’y a pas besoin d’architectures complexes : il faut savoir ce que l’on charge et pourquoi, et ne charger que cela. La compression, traitée dans l’article sur Brotli, Gzip et Zstandard, réduit les octets transférés ; réduire le code réduit aussi le travail, et c’est là que se joue l’INP.
