Cela arrive souvent : le site ralentit, le temps de réponse du serveur augmente, le panneau de l’hébergeur signale une utilisation du processeur proche de la limite, mais Google Analytics n’affiche aucune hausse de visiteurs. La raison est qu’une part croissante du trafic d’un site ne vient pas de personnes. Les robots d’exploration des moteurs de recherche, les robots qui collectent du contenu pour les modèles d’IA, les outils d’analyse SEO, les scrapers qui copient prix et textes, les scans automatisés à la recherche de vulnérabilités : tous demandent des pages au serveur, et beaucoup n’apparaissent pas dans les outils d’analytics parce qu’ils n’exécutent pas JavaScript.
Ce trafic n’est pas mesuré par les Core Web Vitals, qui ne collectent que des données d’utilisateurs réels. Mais il les affecte, parce qu’il consomme les mêmes ressources que celles dont on a besoin pour répondre aux utilisateurs. Dans cet article, nous voyons comment le reconnaître, pourquoi il pèse plus que le nombre de requêtes ne le laisserait penser, et comment le filtrer sans nuire au référencement ni aux services légitimes.
Qui sont les visiteurs automatisés
Tout le trafic automatisé n’est pas indésirable, et distinguer les catégories est la première étape pour décider quoi faire :
- les robots des moteurs de recherche, comme Googlebot et Bingbot : essentiels pour le référencement, en général bien élevés, ils respectent le fichier robots.txt et adaptent leur rythme à la capacité du serveur ;
- les robots d’IA : ils collectent du contenu pour entraîner des modèles ou répondre aux questions des utilisateurs. Certains s’identifient et respectent robots.txt, d’autres non ; certains téléchargent un grand nombre de pages en peu de temps ;
- les outils SEO et de monitoring : des services qui analysent liens, positions et contenus pour le compte de leurs clients, souvent pour des sites concurrents ;
- les scrapers : des programmes qui copient prix, fiches produit ou articles, souvent sous de fausses identités pour ne pas être reconnus ;
- les scans et les attaques : des requêtes automatisées qui cherchent des pages de connexion, des fichiers de configuration exposés, des vulnérabilités connues de plugins, ou qui essaient des mots de passe sur
wp-login.phpetxmlrpc.php; - les services légitimes : monitoring de disponibilité, lecteurs de flux, aperçus de liens sur les réseaux sociaux, notifications des systèmes de paiement. Peu de requêtes, mais il ne faut pas les bloquer.
Pourquoi ils pèsent plus que leurs requêtes
Un site bien configuré sert la plupart des pages aux utilisateurs depuis le cache de page : la page d’accueil, les articles récents, les principales catégories. Les gens ont tendance à visiter les mêmes pages, et ces pages sont presque toujours déjà prêtes. Les bots se comportent autrement. Un robot qui veut lire tout le site demande aussi les articles d’il y a dix ans, la page d’archive numéro 200, les combinaisons de filtres d’une boutique, les résultats de la recherche interne. Ce sont des pages que le cache ne contient pas, et qui exigent donc d’exécuter PHP et d’interroger la base de données.
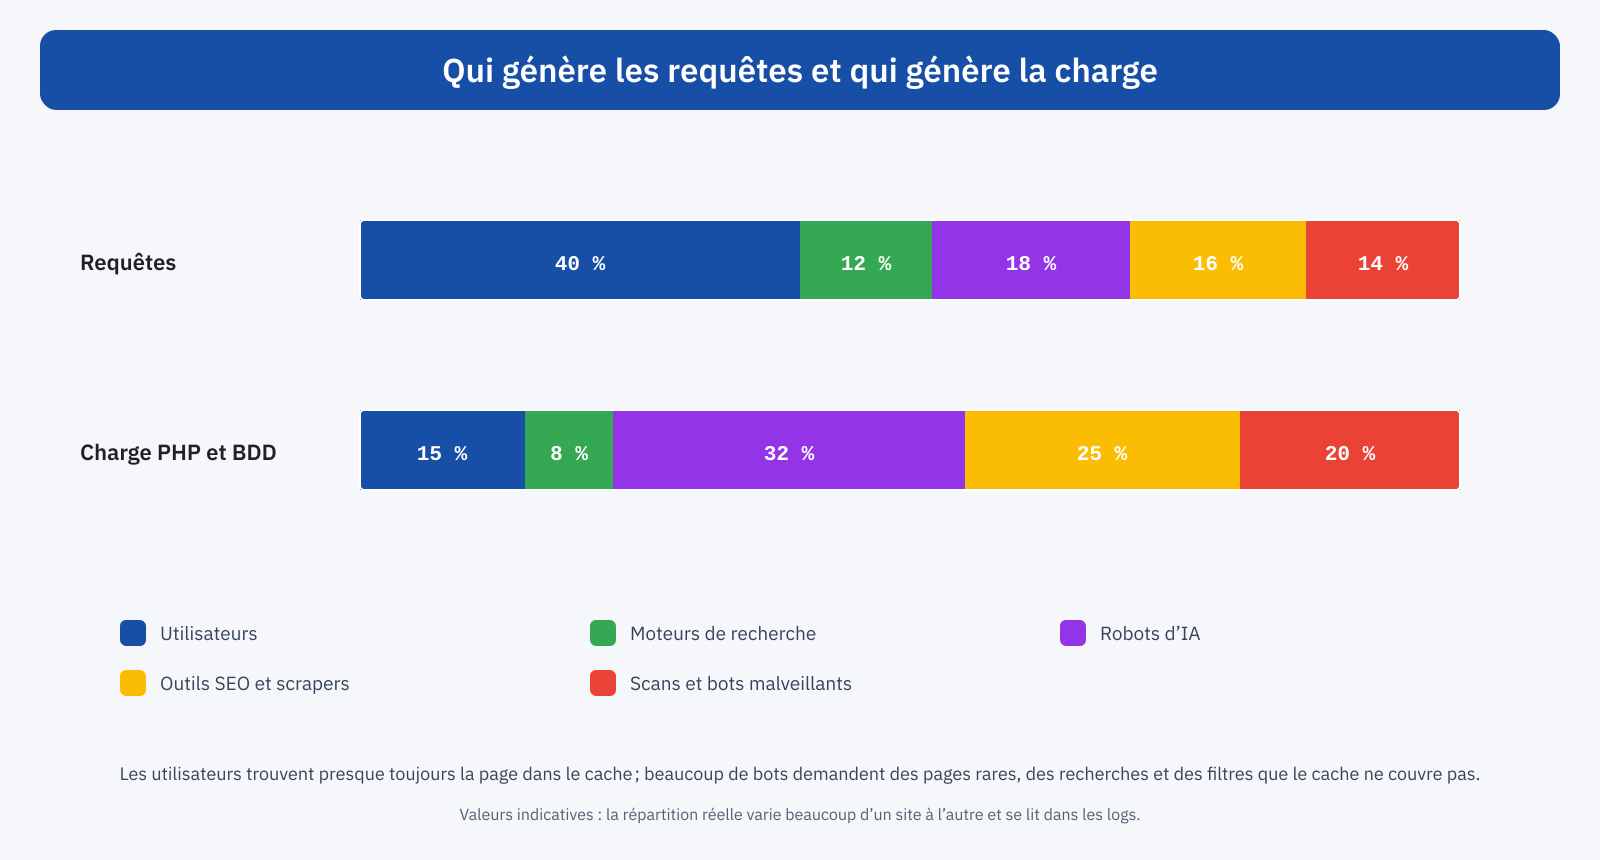
Résultat : les bots, même quand ils génèrent une part minoritaire des requêtes, peuvent générer l’essentiel du travail du serveur. Sur les boutiques en ligne, le problème est amplifié par la navigation à facettes : chaque combinaison de filtres, de tris et de pages est une URL différente, et un robot qui suit tous les liens peut générer des millions de requêtes, dont chacune exécute des requêtes coûteuses, comme nous l’avons vu à propos de WooCommerce et de la base de données WordPress.
Quand le serveur est occupé à répondre aux bots, les requêtes des utilisateurs attendent dans une file. Le TTFB augmente, et avec lui le LCP. Les requêtes dynamiques des utilisateurs, comme le panier, le paiement et l’espace client, sont les plus touchées, parce qu’elles ne peuvent pas être servies depuis le cache. C’est le même mécanisme que celui décrit pour les pics de trafic, sauf que ce pic n’amène aucun client.
Les reconnaître : les logs du serveur
Les outils d’analyse basés sur JavaScript, comme nous l’avons vu à propos des analytics, ne voient que les visiteurs qui exécutent les scripts, c’est-à-dire presque exclusivement des personnes. Pour voir les bots, il faut regarder les logs d’accès du serveur web ou du CDN, qui enregistrent chaque requête avec l’adresse IP, la date, l’URL demandée, le code de réponse, la taille et le user agent. Même sans outils dédiés, quelques commandes donnent une image claire :
# Les 20 user agents qui font le plus de requêtes
awk -F'"' '{print $6}' access.log | sort | uniq -c | sort -rn | head -20

# Les 20 adresses IP qui font le plus de requêtes
awk '{print $1}' access.log | sort | uniq -c | sort -rn | head -20

# Requêtes de recherche interne et de filtres
grep -cE '\?s=|filter_|orderby=' access.log
Si le serveur enregistre aussi le temps de traitement de chaque requête, on peut aller au-delà du simple comptage et additionner le temps par user agent ou par adresse : c’est le chiffre qui dit vraiment qui consomme les ressources. De nombreux panneaux d’hébergement et de nombreux CDN proposent des statistiques déjà agrégées, avec la distinction entre trafic humain et trafic automatisé. Pour Googlebot, le rapport sur les statistiques d’exploration de la Search Console montre le nombre de requêtes par jour et le temps de réponse moyen constaté par le robot.
Une précaution : le user agent est déclaré par celui qui fait la requête et peut être faux. Beaucoup de scrapers se font passer pour Googlebot ou pour un navigateur ordinaire. Pour vérifier qu’une requête vient bien de Google, on effectue une résolution DNS inverse sur l’adresse IP, qui doit renvoyer un nom dans les domaines de Google, suivie d’une résolution directe pour confirmer ; sinon, Google et les autres grands moteurs de recherche publient les plages d’adresses de leurs robots.
Robots.txt : utile mais facultatif
Le fichier robots.txt indique aux robots les parties du site à ne pas visiter. C’est le premier outil à utiliser, parce que les robots légitimes le respectent et qu’il ne coûte rien : exclure les résultats de la recherche interne, les combinaisons de filtres et les pages du panier et du compte réduit immédiatement les requêtes inutiles des moteurs de recherche et des robots bien élevés.
User-agent: *
Disallow: /?s=
Disallow: /*?*filter_
Disallow: /*?*orderby=
Disallow: /carrello/
Disallow: /mio-account/

# Robots d’IA que l’on ne veut pas laisser entrer
User-agent: GPTBot
User-agent: CCBot
Disallow: /
La limite est que robots.txt est une demande, pas un blocage : les bots qui ne le respectent pas, ou qui présentent une fausse identité, l’ignorent. De plus, certaines directives ne sont pas prises en charge par tous : la directive Crawl-delay, par exemple, est respectée par certains moteurs mais pas par Google, qui adapte son rythme en fonction de la réponse du serveur. Il n’y a pas de réponse unique à la question de bloquer ou non les robots d’IA : cela dépend de l’importance que le site accorde à la visibilité dans les réponses des assistants et du poids de ce trafic. L’essentiel est que ce soit un choix conscient, fondé sur les données des logs. Bloquer Googlebot ou Bingbot, en revanche, a des effets directs sur le référencement et doit être évité.
Filtrer avant l’origine
Le principe le plus important est d’arrêter les requêtes indésirables le plus loin possible de PHP et de la base de données. Une requête bloquée par le CDN ne coûte rien au serveur ; une requête bloquée par un plugin de sécurité WordPress coûte presque autant que la servir, parce que pour atteindre le plugin WordPress doit de toute façon démarrer.
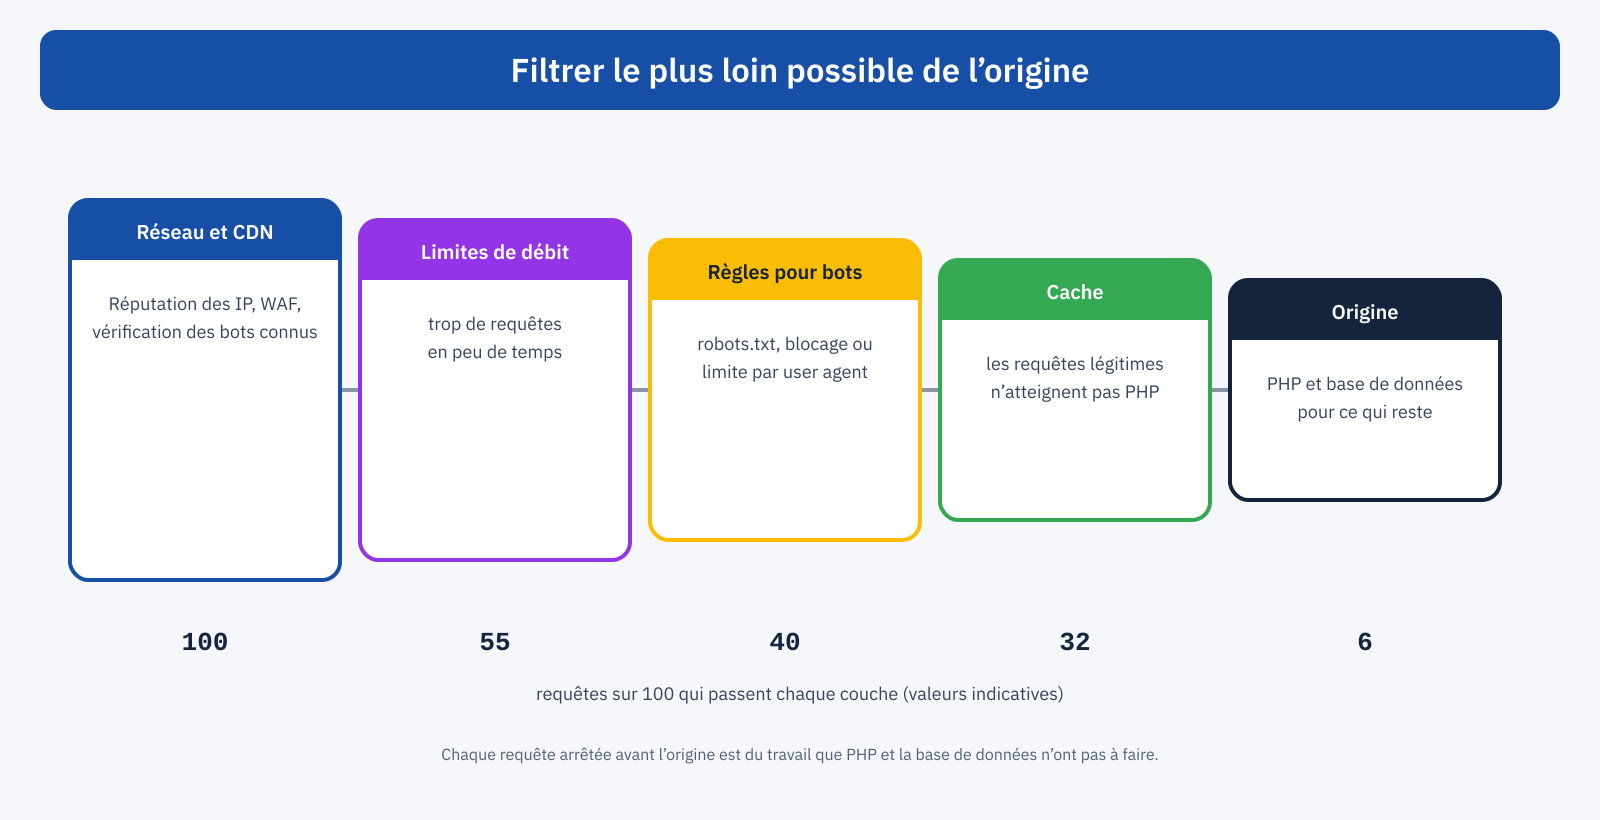
Les couches de défense, de la plus externe à la plus interne, sont les suivantes :
- CDN et pare-feu applicatif (WAF) : ils bloquent les requêtes provenant d’adresses de mauvaise réputation et les tentatives d’attaque connues, et beaucoup proposent la vérification des robots légitimes et des règles spécifiques pour les robots d’IA. Comme on l’a vu dans l’article sur Cloudflare, ce ne sont pas des solutions universelles, mais pour ce travail ce sont les outils les plus efficaces ;
- limites de débit (rate limits) : un nombre maximal de requêtes par adresse dans un intervalle de temps, appliqué par le CDN ou le serveur web, arrête les bots les plus agressifs sans toucher les personnes, qui ne demandent pas des dizaines de pages par seconde ;
- règles par user agent et par chemin : des blocages ciblés pour les bots qui ne respectent pas robots.txt, et la protection des chemins sensibles comme
wp-login.phpetxmlrpc.php, ce dernier à désactiver s’il n’est pas utilisé ; - cache : servir aussi depuis le cache les requêtes légitimes des bots, en évitant que des paramètres inutiles, comme ceux de suivi ou les paramètres aléatoires, génèrent des versions différentes de la même page ;
- origine : seules les requêtes qui doivent vraiment être traitées atteignent l’application.
Au niveau du serveur web, une limite de débit se met en place en quelques lignes. Un exemple pour Nginx, qui limite les recherches internes à deux requêtes par seconde et par adresse, avec une petite tolérance pour les rafales :
# Dans le bloc http : la clé est vide (donc pas de limite) s’il ne s’agit pas d’une recherche
map $arg_s $chiave_ricerca {
	""      "";
	default $binary_remote_addr;
}
limit_req_zone $chiave_ricerca zone=ricerca:10m rate=2r/s;

# Dans le bloc server
server {
	# ...
	limit_req zone=ricerca burst=5 nodelay;
	limit_req_status 429;
}
La configuration exacte dépend du serveur et de l’hébergement, et doit être testée avec soin : une limite trop serrée peut bloquer de vrais utilisateurs qui partagent la même adresse, comme les salariés d’une entreprise ou les clients d’un opérateur mobile.
Réduire ce que les bots peuvent demander
Outre le filtrage, il vaut la peine de réduire la surface que les bots peuvent explorer. Les combinaisons de filtres d’une boutique peuvent utiliser des liens que les robots ne suivent pas, ou des paramètres exclus dans robots.txt ; les pages de recherche interne peuvent être exclues de l’indexation ; les étiquettes et les archives peu utilisées peuvent être supprimées. Les réponses d’erreur, comme les pages introuvables, doivent être légères et, si possible, mises en cache pour une courte durée : les scans génèrent des milliers de requêtes vers des URL inexistantes, et dans beaucoup d’installations chacune exécute tout WordPress.
Autre point : wp-cron, qui dans WordPress est déclenché par les visites : avec beaucoup de trafic automatisé, il tourne en continu. Le remplacer par une tâche planifiée au niveau du système, à intervalles réguliers, supprime une charge inutile. Enfin, un object cache persistant réduit le coût des requêtes qui atteignent quand même l’origine.
Ce qu’il ne faut pas bloquer
Le risque inverse est de bloquer trop. Outre les moteurs de recherche, il faut laisser passer les services dont le site a besoin : notifications des systèmes de paiement, services de monitoring, lecteurs de flux, systèmes qui génèrent les aperçus de liens sur les réseaux sociaux et dans les messageries, intégrations avec les logiciels de gestion et les places de marché. Avant d’activer un blocage général, comme une vérification obligatoire pour tout le trafic non reconnu, il vaut la peine de regarder dans les logs quels services légitimes accèdent au site et de prévoir des exceptions. Chaque modification doit ensuite être surveillée pendant quelques jours, en vérifiant les erreurs dans les logs et dans le rapport d’exploration de la Search Console.
Un exemple concret
Une boutique en ligne d’environ deux mille produits remarque que le TTFB des pages de catégorie, dans les données d’utilisateurs réels, a doublé en quelques semaines, sans modification du site et sans hausse des visites dans les analytics. Les logs montrent que plus de la moitié des requêtes viennent de quelques robots qui explorent toutes les combinaisons de filtres, et que certains se présentent comme un navigateur ordinaire mais proviennent de quelques plages d’adresses de fournisseurs cloud. La solution consiste à exclure les paramètres de filtres dans robots.txt, à activer dans le CDN la vérification des robots connus et une limite de débit par adresse sur les pages filtrées, et à bloquer les plages d’adresses d’où vient le scraping. La charge du serveur chute de façon spectaculaire, et le TTFB des utilisateurs retrouve ses valeurs précédentes, sans toucher une ligne du thème.
En bref
Une part importante du travail des serveurs est effectuée pour des visiteurs qui ne sont pas des personnes. Les bots demandent souvent des pages que le cache ne couvre pas, et pèsent donc sur le serveur plus que le nombre de leurs requêtes ne le suggère ; quand le serveur est saturé, ce sont les vrais utilisateurs qui paient, avec un TTFB et un LCP dégradés. Pour s’attaquer au problème, il faut les logs du serveur, parce que les outils d’analytics ne voient pas les bots ; il faut distinguer les robots utiles des robots indésirables, en vérifiant les identités déclarées ; et il faut des défenses à plusieurs niveaux, le plus loin possible de l’origine : robots.txt, CDN et WAF, limites de débit, un cache efficace pour les bots aussi. Le tout en laissant la porte ouverte aux services dont le site a besoin.
