Optimiser un site est difficile ; le garder optimisé l’est encore plus. Quiconque a suivi un projet de performance connaît bien la séquence : des semaines de travail, des Core Web Vitals enfin au vert, la satisfaction générale. Puis, mois après mois, arrivent un nouveau plugin d’avis, un pixel pour une campagne, un carrousel sur la page d’accueil, une police supplémentaire pour un titre, un script de chat. Aucune de ces modifications, prise isolément, ne semble grave. Un an plus tard, le site est aussi lent qu’avant, et personne ne sait exactement quand ni pourquoi.
Le budget de performance est l’outil qui brise cette séquence. C’est un ensemble de limites explicites, partagées et vérifiées automatiquement sur ce qu’une page peut peser et sur la manière dont elle doit se comporter. Il n’empêche pas le site d’évoluer, mais il rend visible le coût de chaque ajout et impose une décision consciente quand on veut le dépasser. Dans cet article, nous voyons quels types de budget existent, comment les définir, comment les vérifier automatiquement et comment les faire fonctionner dans l’organisation.
Pourquoi les sites redeviennent lents
La dégradation de la performance au fil du temps n’est pas un accident, mais une tendance naturelle. Chaque service a de bonnes raisons d’ajouter quelque chose : le marketing un nouvel outil de suivi, les ventes un chat, le design une animation, le contenu des images plus grandes et des vidéos intégrées. Chaque ajout apporte un bénéfice visible à celui qui le demande et un coût de performance réparti sur tout le monde, à peine visible et difficile à attribuer. Sans mécanisme qui rende ce coût explicite, la somme de décisions raisonnables produit un site lent.
Il y a aussi un problème de délai. Les données de terrain du Chrome UX Report, celles qui comptent pour Google, sont mises à jour sur une fenêtre de 28 jours : une régression introduite aujourd’hui ne devient pleinement visible qu’au bout de plusieurs semaines, quand d’autres mises en production sont passées entre-temps et que la cause est difficile à isoler. Un budget vérifié à chaque mise en production repère le problème au moment où il est introduit, quand il est encore facile de retrouver qui l’a causé et pourquoi.
Trois types de budget
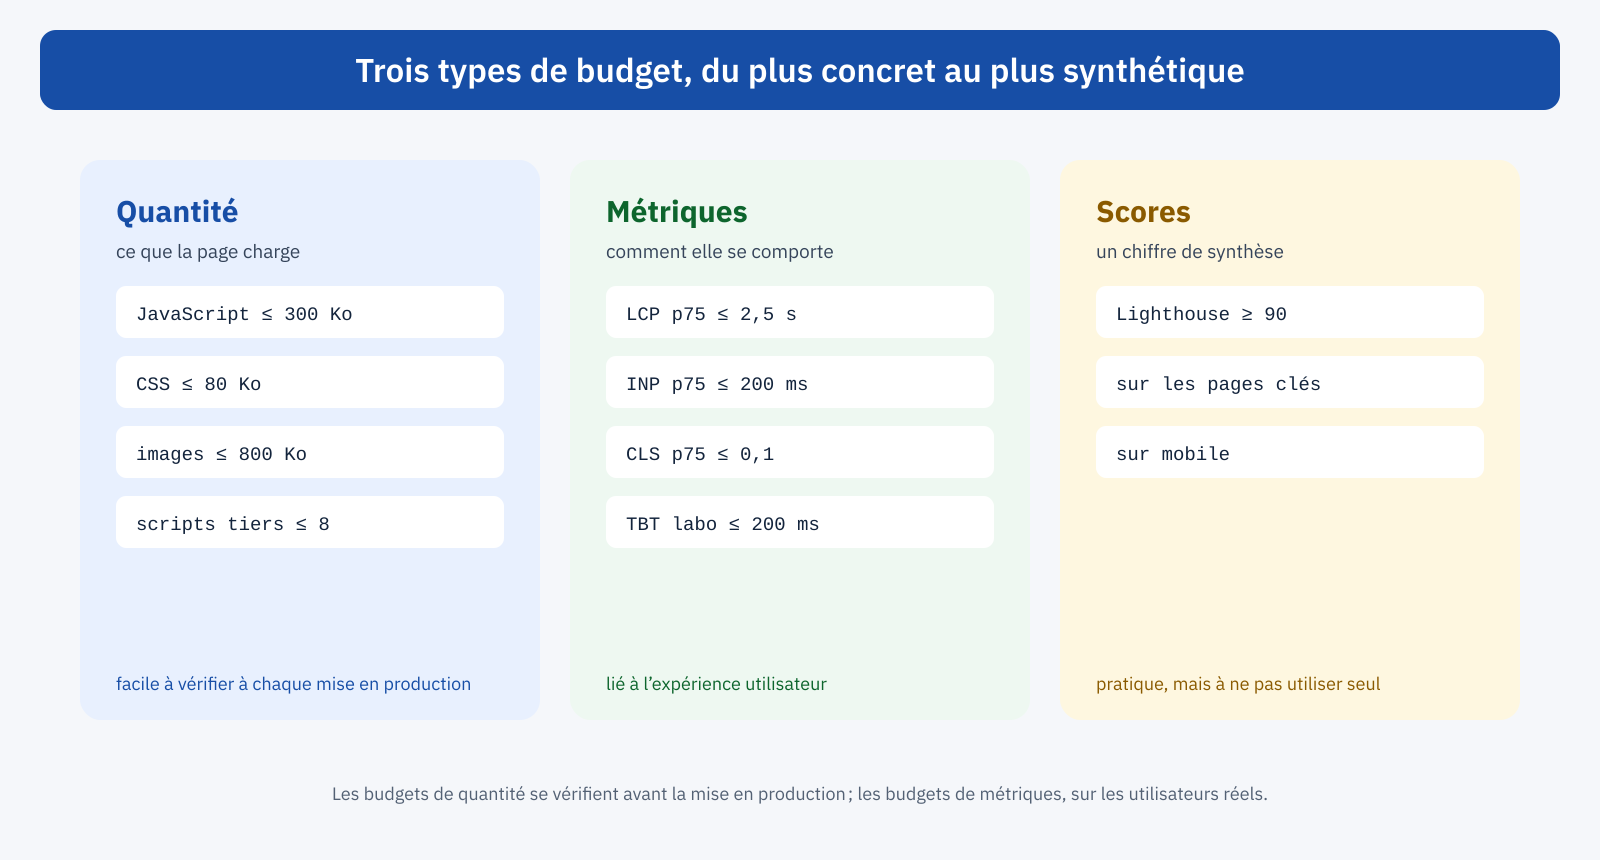
Les budgets de performance se répartissent en trois familles, chacune avec des avantages et des limites différents. En pratique, on les utilise ensemble.
Les budgets de quantité
Les budgets de quantité fixent des limites à ce que la page charge : kilooctets de JavaScript, de CSS, d’images et de polices, nombre de requêtes, nombre de domaines ou de scripts tiers. Ce sont les plus concrets et les plus faciles à comprendre pour tous : « le JavaScript de la fiche produit ne doit pas dépasser 300 kilooctets compressés » est une règle qu’un designer, un développeur et un responsable marketing comprennent de la même façon. Ils sont aussi faciles à vérifier automatiquement et de manière fiable, car ils ne dépendent pas de la variabilité du réseau ni de l’appareil de test.
Leur limite est qu’ils mesurent une cause, pas un effet : une page peut respecter le budget JavaScript et rester lente à cause d’un serveur sans cache ou d’une image principale chargée tard. C’est pourquoi il faut les associer à des budgets de métriques.
Les budgets de métriques
Les budgets de métriques fixent des limites aux temps : LCP, INP et CLS au 75e percentile des données de terrain, ou valeurs de laboratoire comme le LCP et le Total Blocking Time mesurés dans un test contrôlé. Ils sont directement liés à l’expérience utilisateur et aux objectifs business, et le point de départ naturel est constitué par les seuils des Core Web Vitals. La limite est la variabilité : les tests de laboratoire fluctuent d’une exécution à l’autre, et les données de terrain arrivent avec un retard. Ils demandent donc plus de soin dans la configuration, par exemple en répétant les tests plusieurs fois et en utilisant la médiane.
Les budgets de scores
Les budgets de scores fixent un minimum pour un indice de synthèse, comme le score de performance de Lighthouse. Ils sont pratiques à communiquer, mais un score agrège de nombreuses métriques avec des pondérations qui changent d’une version de l’outil à l’autre, et il peut être amélioré par des techniques qui n’améliorent pas l’expérience réelle, comme nous l’avons vu à propos du cloaking de performance. Ils peuvent venir en complément des autres budgets, mais pas les remplacer.
Comment définir les limites
Un budget utile n’est ni trop généreux, car il ne protège rien, ni trop strict, car il est ignoré à la première difficulté. Quelques critères aident à trouver le bon équilibre.
- Partir de la situation actuelle. Si le site est déjà au vert, le budget initial peut être la situation actuelle avec une petite marge : l’objectif est de ne pas se dégrader. Sinon, fixez un budget atteignable et abaissez-le progressivement à mesure que les modifications produisent des résultats.
- Raisonner à rebours à partir des métriques. Pour obtenir un LCP de 2,5 secondes sur un réseau mobile de référence, combien de kilooctets peut peser le chemin critique ? Le calcul, même approximatif, transforme un objectif de temps en limites de quantité vérifiables.
- Regarder les concurrents. La performance des principaux concurrents, mesurée avec les mêmes outils, est une référence utile, surtout pour convaincre les décideurs : être plus rapide que la concurrence est un argument facile à comprendre.
- Distinguer par modèle de page. Une page d’accueil, une fiche produit et un article n’ont pas les mêmes besoins. Un budget unique pour tout le site est trop lâche pour certaines pages et trop serré pour d’autres.
- Penser mobile. Les limites doivent être fixées pour les conditions les plus difficiles, un smartphone de milieu de gamme sur un réseau mobile : c’est là que se mesurent les Core Web Vitals les plus critiques.
Des contrôles automatisés avant la mise en production
Un budget vérifié à la main, de temps en temps, est vite oublié. Sa valeur réside dans le contrôle automatisé, exécuté à chaque modification du site avant qu’elle n’arrive en production. L’outil le plus répandu est Lighthouse CI, qui exécute Lighthouse sur une liste de pages, compare les résultats aux seuils configurés et signale, ou bloque, les mises en production qui les dépassent.
{
	"ci": {
		"collect": {
			"url": [
				"https://staging.example.com/",
				"https://staging.example.com/category/shoes/",
				"https://staging.example.com/product/trail-shoe/"
			],
			"numberOfRuns": 3
		},
		"assert": {
			"assertions": {
				"largest-contentful-paint": [ "error", { "maxNumericValue": 2500 } ],
				"cumulative-layout-shift": [ "error", { "maxNumericValue": 0.1 } ],
				"total-blocking-time": [ "warn", { "maxNumericValue": 200 } ],
				"resource-summary:script:size": [ "error", { "maxNumericValue": 300000 } ],
				"resource-summary:stylesheet:size": [ "warn", { "maxNumericValue": 80000 } ],
				"resource-summary:third-party:count": [ "warn", { "maxNumericValue": 8 } ]
			}
		}
	}
}
Dans l’exemple, le fichier de configuration lighthouserc.json liste trois pages représentatives des principaux modèles, répète chaque test trois fois pour réduire la variabilité, et définit deux niveaux de gravité : les erreurs bloquent la mise en production, les avertissements la signalent sans la bloquer. Une bonne pratique consiste à démarrer avec tous les contrôles en mode avertissement, à observer la variabilité des résultats pendant quelques semaines, puis seulement à transformer en erreurs les limites les plus stables, comme celles sur le poids des ressources.
Le contrôle se branche sur le système d’intégration continue utilisé par le projet. Avec GitHub Actions, par exemple, quelques lignes suffisent :
name: Performance budget
on: [ pull_request ]
jobs:
  lighthouse:
    runs-on: ubuntu-latest
    steps:
      - uses: actions/checkout@v4
      - run: npm ci && npm run build && npm run deploy:staging
      - run: npx @lhci/cli autorun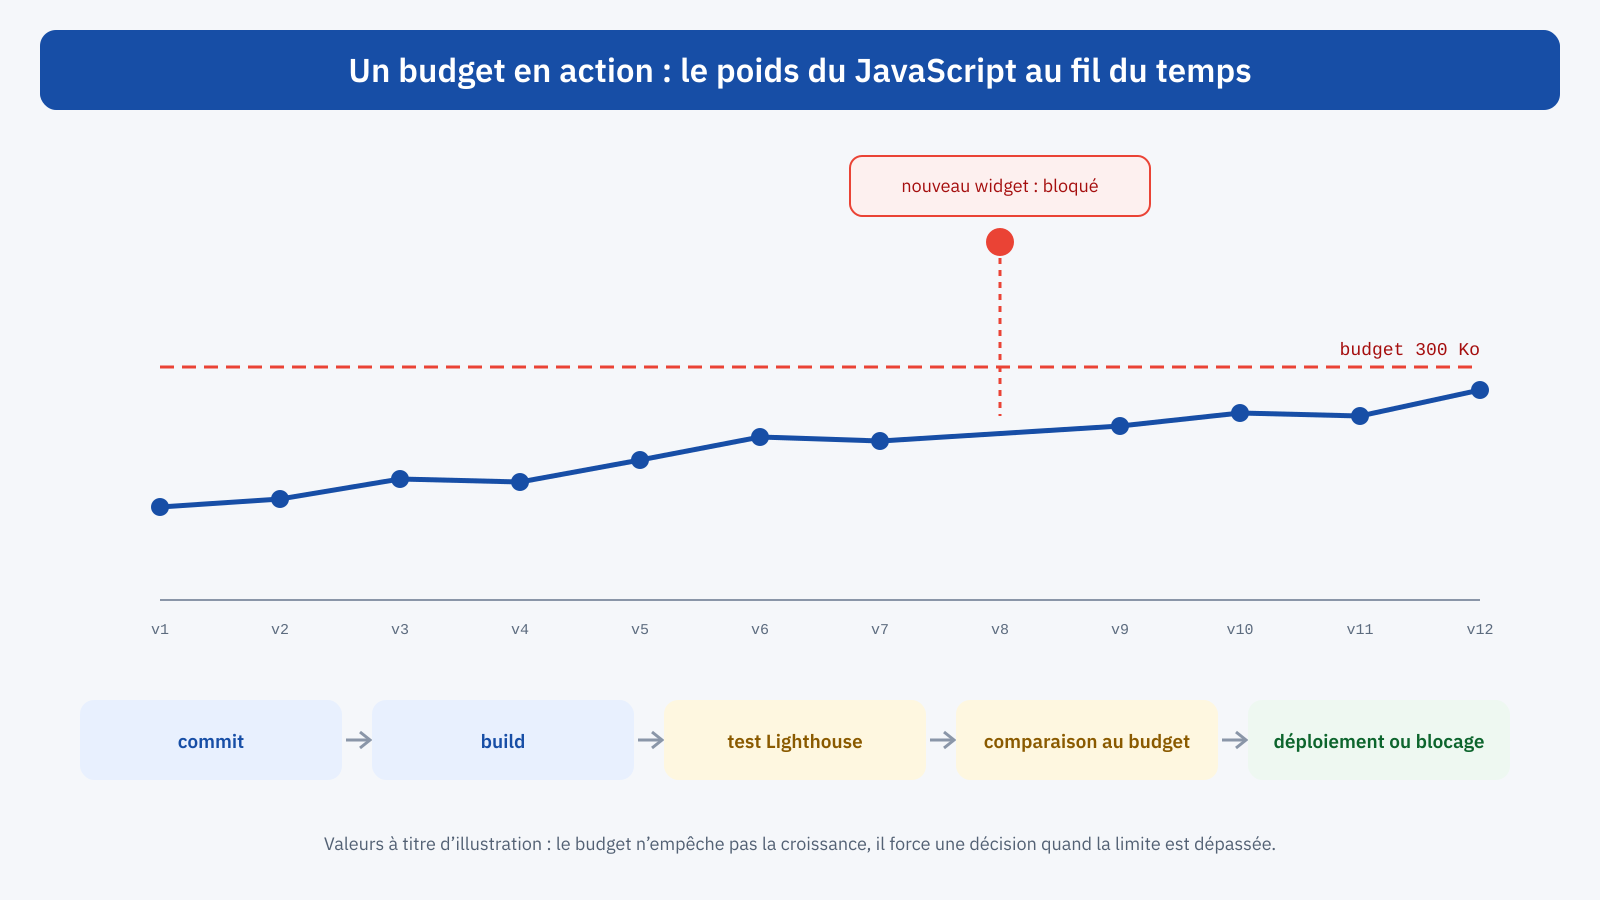
Pour les projets dotés d’un processus de build front-end, il existe aussi des contrôles plus ciblés, exécutés directement sur les fichiers produits : des outils comme size-limit, ou les avertissements de taille de bundle des principaux bundlers, signalent immédiatement qu’une nouvelle dépendance fait dépasser la limite au JavaScript, avant même d’exécuter un test dans le navigateur.
Des contrôles après la mise en production
Les contrôles avant la mise en production ne voient que ce qui passe par le code. De nombreuses régressions viennent pourtant de l’extérieur : une balise ajoutée par le marketing via le gestionnaire de balises, un widget tiers qui se met à jour, une image énorme téléversée par un rédacteur, une campagne qui amène du trafic depuis des appareils plus lents. Pour cela, il faut un second niveau de contrôle, sur des données d’utilisateurs réels.
Un système de Real User Monitoring permet de définir des alertes sur le 75e percentile des métriques par modèle de page : si le LCP des fiches produit en mobile dépasse le seuil deux jours de suite, ou se dégrade de plus de 10 % par rapport à la semaine précédente, quelqu’un reçoit une notification. Même un simple contrôle périodique des données de l’API CrUX, avec une comparaison hebdomadaire, vaut mieux que rien. L’objectif est de repérer un problème en quelques jours, pas en quelques mois.
Des budgets pour ce qui ne passe pas par le code
Certaines des sources de régression les plus courantes ne peuvent pas être contrôlées par un test automatisé sur le code, et demandent des règles de processus. Il y en a deux principales.
La première, ce sont les scripts tiers. Un budget sur le nombre et le poids des scripts externes, avec un registre de qui les a demandés, à quoi ils servent et jusqu’à quand, transforme l’ajout d’une nouvelle balise d’un geste automatique en une décision : si l’on veut ajouter un outil au-delà de la limite, on en retire un autre ou on justifie l’exception. Le gestionnaire de balises, qui permet d’ajouter des scripts sans passer par les développeurs, est le point où cette règle doit être appliquée.
La seconde, c’est le contenu. Des images téléversées en pleine résolution, des vidéos intégrées sans façade, des sections de page d’accueil construites avec des blocs lourds. Dans WordPress, certaines règles peuvent être appliquées automatiquement, comme le redimensionnement des images trop grandes au téléversement, que le cœur fait déjà au-delà d’un certain seuil, et la conversion vers des formats modernes. Pour le reste, il faut des consignes simples pour les rédacteurs et un contrôle périodique des pages les plus visitées.
Que se passe-t-il quand le budget est dépassé
Un budget n’a de sens que si le dépasser a des conséquences, et les conséquences doivent être décidées à l’avance. Il y a trois options : optimiser la nouvelle fonctionnalité jusqu’à ce qu’elle rentre dans la limite ; retirer autre chose pour faire de la place ; accepter consciemment le dépassement, en mettant à jour le budget avec une justification explicite. Les trois sont légitimes. Ce que le budget empêche, c’est la quatrième option, la plus courante sans budget : dépasser la limite sans s’en apercevoir.
Pour que cela fonctionne, il faut un responsable : une personne ou un groupe qui s’occupe des budgets, décide des exceptions et en répond. Sans responsable, le premier dépassement urgent, peut-être à la veille d’une campagne, devient le précédent qui vide la règle de sa substance. Relier les budgets aux objectifs business, comme le montre l’article sur le retour sur investissement de la performance web, les rend beaucoup plus faciles à défendre quand quelqu’un demande à les dépasser.
Un exemple pour démarrer
Pour un site WordPress de taille moyenne, un ensemble initial raisonnable pourrait être le suivant, à adapter à la situation réelle :
- JavaScript compressé par page : au maximum 300 kilooctets, dont pas plus de 100 de scripts tiers.
- CSS compressé par page : au maximum 80 kilooctets.
- Image principale : au maximum 150 kilooctets dans le format servi au mobile.
- Polices : au maximum deux familles, quatre fichiers.
- Laboratoire, mobile, médiane de trois exécutions : LCP sous 2,5 secondes, TBT sous 200 millisecondes, CLS sous 0,1.
- Terrain, 75e percentile par modèle de page : tous les Core Web Vitals au vert, avec une alerte pour les régressions hebdomadaires supérieures à 10 %.
En résumé
Les sites ont tendance à redevenir lents parce que chaque ajout a un bénéfice visible et un coût caché. Le budget de performance rend ce coût explicite : des limites sur la quantité, les métriques et, avec prudence, les scores, définies par modèle de page et pour des conditions mobiles, vérifiées automatiquement avant chaque mise en production avec des outils comme Lighthouse CI et surveillées après la mise en production avec des données d’utilisateurs réels.
La partie technique est la plus facile. Le budget fonctionne vraiment quand il a un responsable, des règles claires pour les exceptions, et qu’il couvre aussi ce qui ne passe pas par le code, comme les scripts tiers et le contenu. C’est l’étape qui transforme un projet d’optimisation, qui finit tôt ou tard, en une qualité du site qu’on entretient dans la durée.
