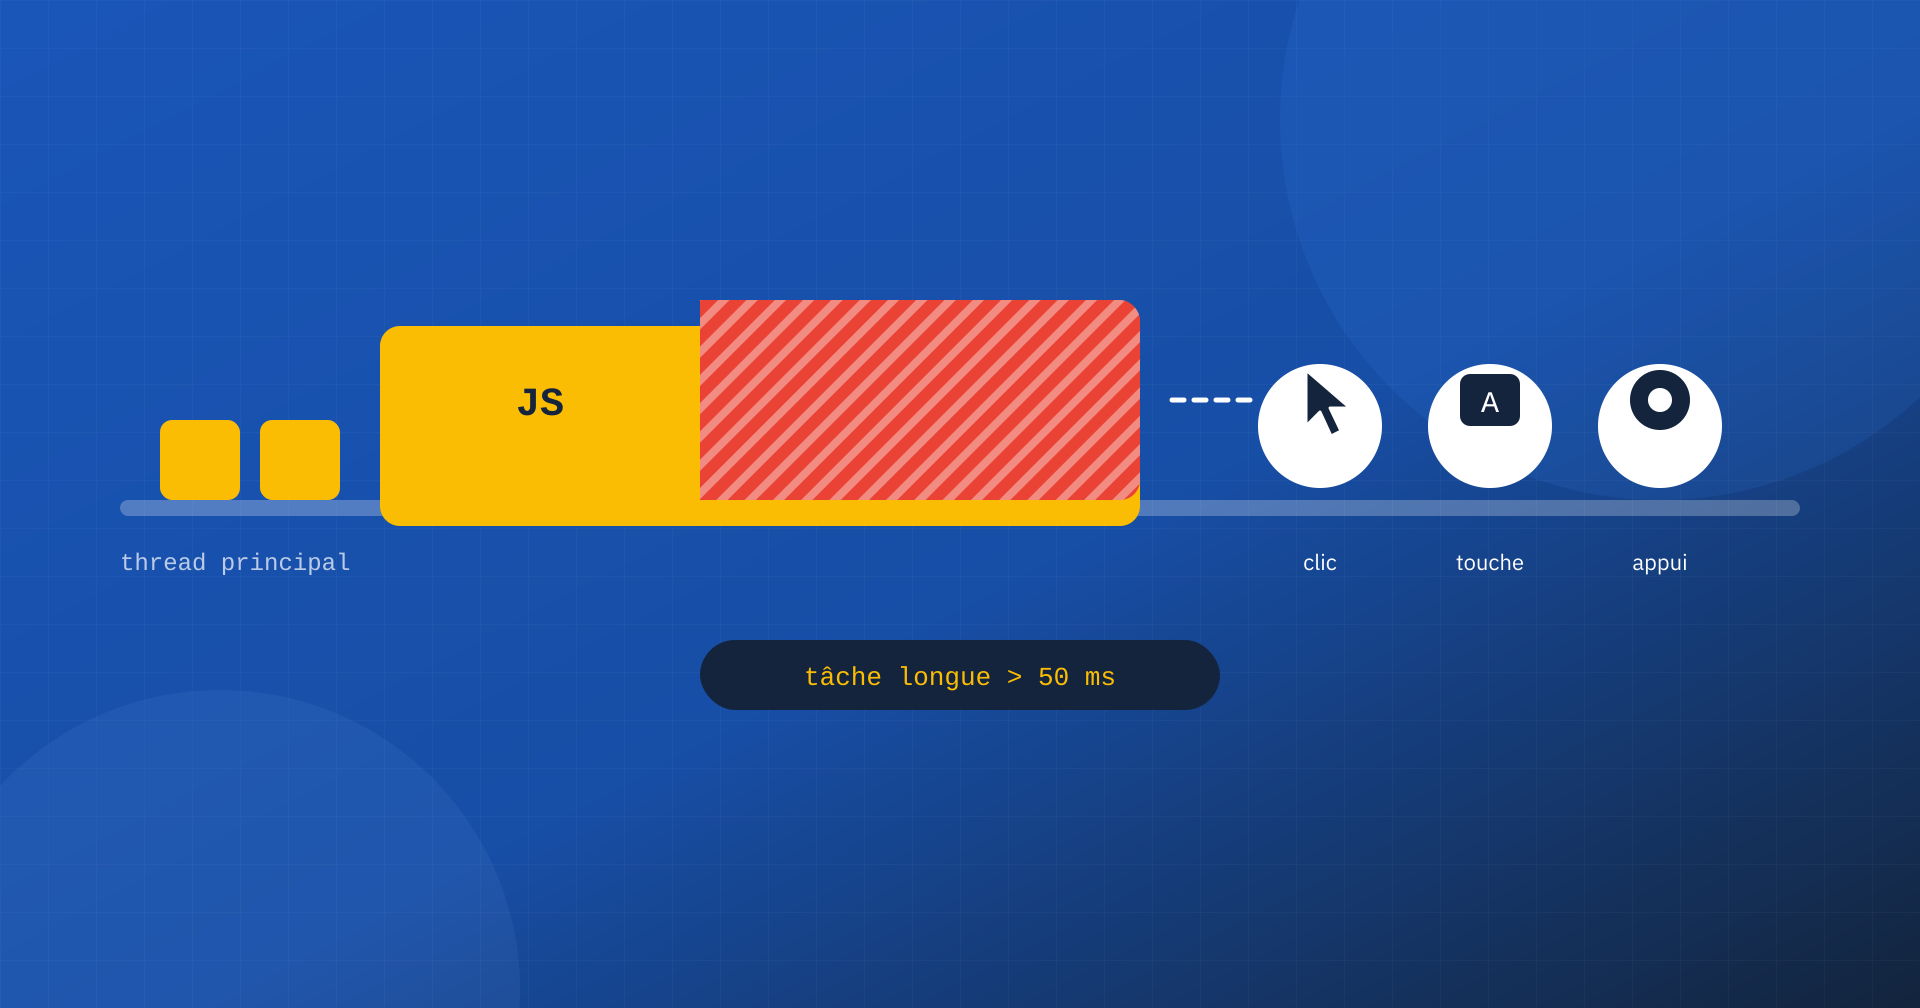
Quiconque travaille sur la performance web rencontre vite trois termes qui reviennent dans tous les rapports : thread principal, tâche longue et Total Blocking Time. Lighthouse vous dit de « réduire l’exécution du thread principal », PageSpeed Insights affiche un TBT en rouge, les DevTools signalent des blocs jaunes avec un petit triangle rouge. Ces notions semblent réservées aux développeurs front-end, mais elles expliquent l’un des problèmes les plus courants et les plus sous-estimés des sites modernes : une page qui a l’air chargée mais ne répond pas.
Dans cet article, nous essayons de les expliquer simplement, en partant du fonctionnement du navigateur, puis en passant à ce que mesurent les métriques, à la manière de trouver les coupables et d’intervenir.
Le thread principal : un seul ouvrier pour presque tout
Pour afficher une page, le navigateur doit accomplir de nombreuses tâches différentes : lire le HTML et construire le DOM, appliquer les feuilles de style, calculer la position et la taille de chaque élément, dessiner, exécuter le JavaScript et répondre aux clics, aux appuis et aux frappes au clavier. Certaines activités, comme le téléchargement des ressources ou le décodage des images, se déroulent en parallèle sur d’autres threads. Mais la plus grande partie du travail lié à la page, et en particulier tout le JavaScript de la page et la gestion des événements, se passe sur un seul thread : le thread principal.
La façon la plus simple de se le représenter est un seul ouvrier qui exécute un travail à la fois, pris dans une file d’attente. Chaque travail, appelé tâche, est terminé avant de passer au suivant : l’ouvrier ne peut pas en interrompre un à mi-chemin pour s’occuper de quelque chose de plus urgent. Si l’utilisateur appuie sur un bouton pendant que le thread principal exécute un script, l’appui est mis en file d’attente et ne sera traité qu’à la fin du script. Entre-temps, la page paraît figée : aucune réaction visuelle, aucun changement, parfois même pas de défilement s’il dépend de gestionnaires d’événements JavaScript.
Ce qu’est une tâche longue
Une tâche longue (long task) est une tâche qui occupe le thread principal pendant plus de 50 millisecondes. Le seuil n’est pas arbitraire : il vient du modèle RAIL proposé par Google, selon lequel une réponse en moins de 100 millisecondes est perçue comme instantanée. Si chaque tâche dure au plus 50 millisecondes, une interaction qui arrive au pire moment attend au maximum 50 millisecondes, et il reste encore 50 millisecondes pour la traiter et afficher le résultat. Au-delà de ce seuil, la probabilité que l’utilisateur perçoive un délai augmente rapidement.
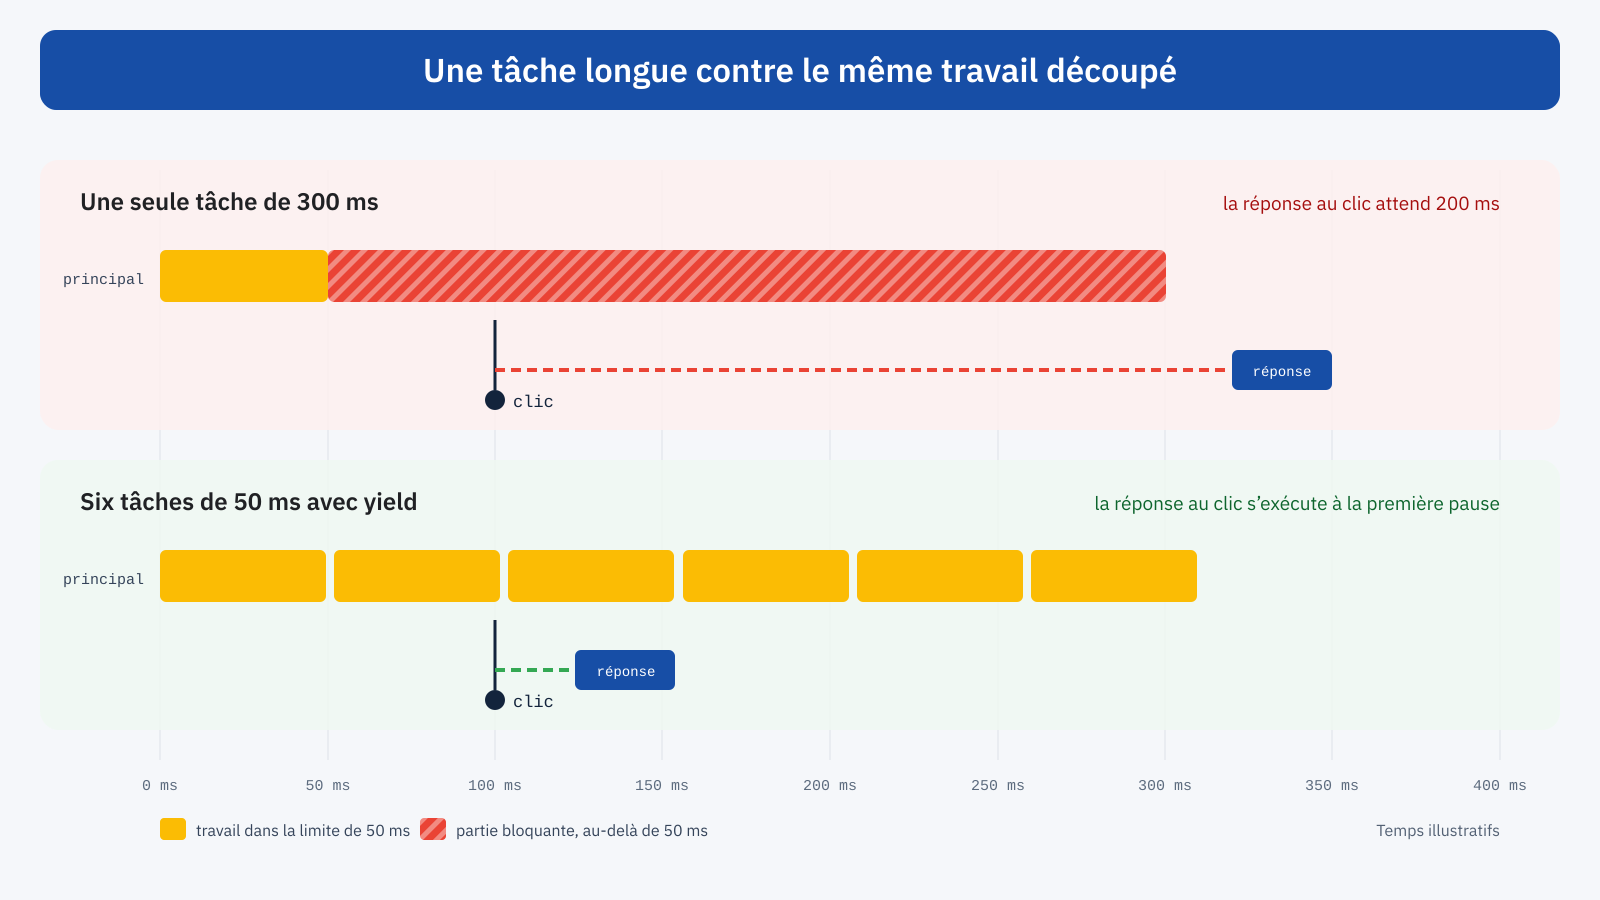
Le problème n’est pas la quantité totale de travail, mais sa répartition. Trois cents millisecondes de JavaScript exécutées d’un seul bloc laissent l’utilisateur attendre pendant toute la durée ; ces mêmes trois cents millisecondes découpées en six blocs de cinquante, avec des pauses entre eux, permettent au navigateur d’insérer la réponse à un clic dans la première pause disponible.
Total Blocking Time
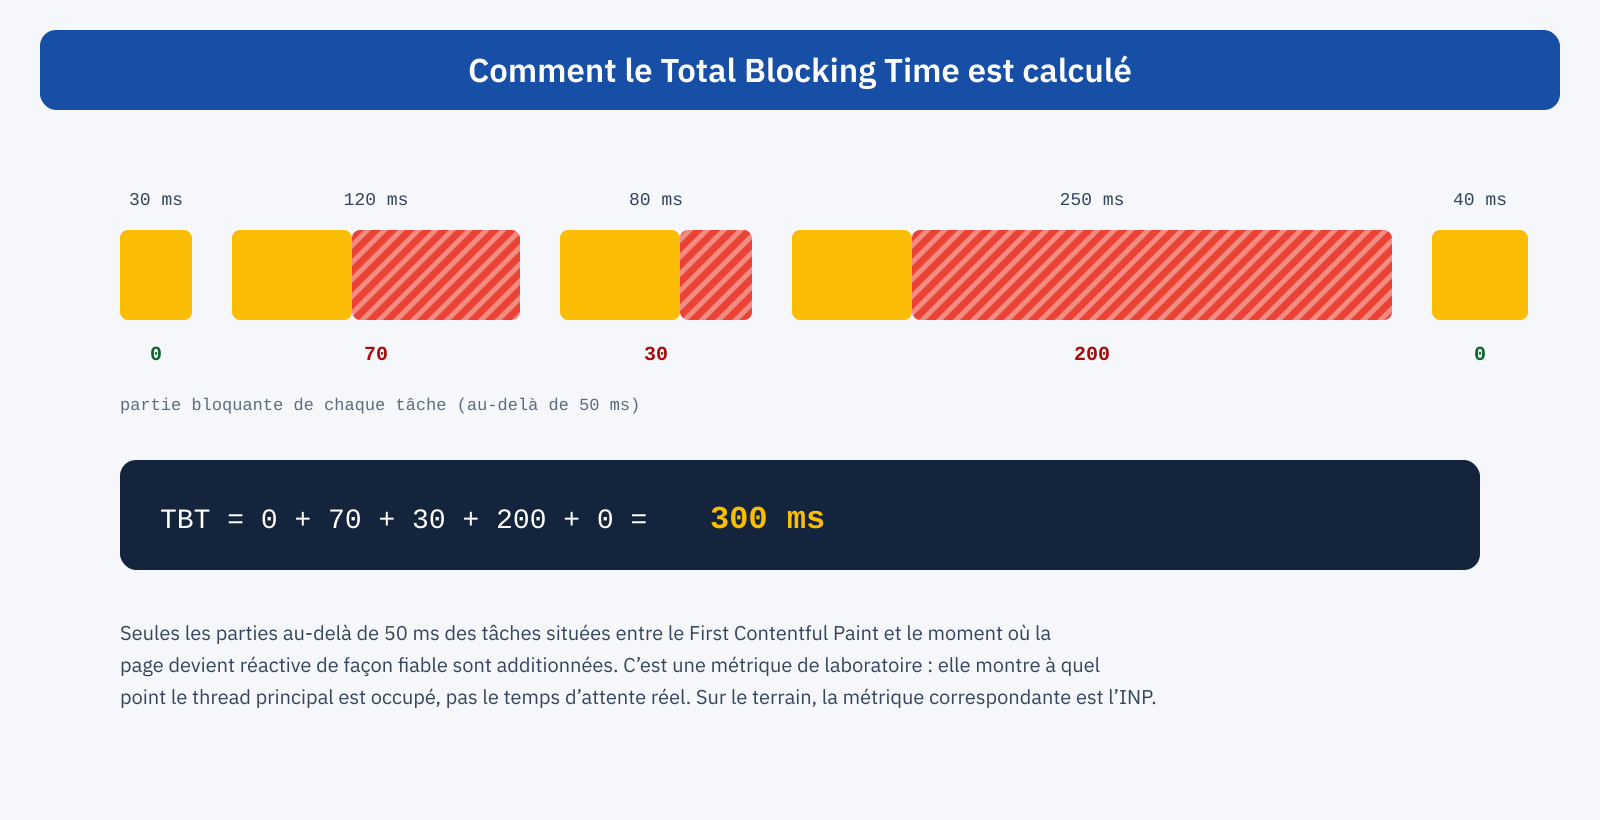
Le Total Blocking Time, ou TBT, est la métrique que Lighthouse utilise pour mesurer à quel point le thread principal est bloqué pendant le chargement. Le calcul est simple : pour chaque tâche longue qui se produit entre le First Contentful Paint et le moment où la page devient réactive de façon fiable, on prend la partie qui dépasse 50 millisecondes, et on additionne toutes ces parties. Une tâche de 120 millisecondes contribue pour 70, une tâche de 40 millisecondes ne contribue pour rien.
Dans le score Lighthouse, le TBT pèse lourd, le plus lourd parmi les métriques prises en compte, et c’est souvent la principale raison pour laquelle un site obtient un score mobile faible. Sur un site desktop, un TBT inférieur à 200 millisecondes est considéré comme bon ; sur mobile, où Lighthouse simule un processeur plus lent, l’atteindre est beaucoup plus exigeant.
Il faut toutefois se rappeler ce qu’est le TBT et ce qu’il n’est pas. C’est une métrique de laboratoire : elle mesure à quel point le thread principal est occupé pendant un chargement simulé, sans que personne n’interagisse avec la page. Elle ne mesure pas combien de temps un utilisateur attend réellement, car il n’y a pas d’utilisateurs dans le test. C’est un indicateur, utile parce qu’il est corrélé à la réactivité réelle, mais ce n’est pas un Core Web Vital et Google ne l’utilise pas pour évaluer les pages. La métrique de terrain correspondante est l’INP, qui mesure le temps de réponse aux interactions réelles d’utilisateurs réels, comme l’explique l’article sur les différences entre PageSpeed Insights et Lighthouse.
Comment les tâches longues touchent les Core Web Vitals
Le lien le plus direct est avec l’INP. Le temps de réponse à une interaction comporte trois parties : le délai avant que le gestionnaire d’événement puisse démarrer, le temps d’exécution du gestionnaire et le temps d’affichage du résultat. Les tâches longues agissent sur les trois. Une tâche longue en cours au moment du clic allonge le délai initial ; un gestionnaire d’événement qui fait trop de travail est lui-même une tâche longue ; une mise à jour du DOM qui exige de lourds recalculs de styles et de mise en page retarde l’affichage.
Mais le LCP en souffre aussi. Si le thread principal est occupé à exécuter des scripts au moment où l’image ou le texte principal est prêt, le navigateur ne peut pas l’afficher tant que le thread n’est pas libre. Sur les pages comportant beaucoup de JavaScript synchrone dans l’en-tête, on voit parfois un LCP arriver des centaines de millisecondes après le téléchargement de l’image, simplement parce que le thread principal était occupé ailleurs.
D’où viennent les tâches longues
- L’évaluation des scripts. Chaque fichier JavaScript doit être analysé, compilé et exécuté. Les gros bundles, avec des bibliothèques entières chargées pour utiliser une seule fonction, produisent des tâches longues au chargement.
- Les scripts tiers. Analytics, pixels, chat, tests A/B et widgets effectuent souvent un travail lourd pendant le chargement même, comme nous l’avons vu à propos des scripts tiers.
- L’hydratation des frameworks. Sur les sites construits avec des frameworks JavaScript, le code qui rend interactive une page rendue côté serveur peut occuper le thread principal pendant des centaines de millisecondes.
- Les recalculs de styles et de mise en page. Un DOM très grand, ou un code qui lit puis modifie tour à tour les dimensions des éléments, oblige le navigateur à recalculer la mise en page plusieurs fois dans la même tâche.
- Le traitement de données. Analyse de gros JSON, tri, filtrage de longues listes exécutés dans un gestionnaire d’événement.
Comment les trouver
Le panneau Performance des DevTools de Chrome est l’outil principal. Quand on enregistre un chargement ou une interaction, la trace du thread principal montre chaque tâche sous forme de bloc ; les tâches longues sont signalées par un triangle rouge et une partie hachurée correspondant à la portion au-delà de 50 millisecondes. Développer un bloc montre la chaîne d’appels et, surtout, le fichier et la fonction responsables. Il vaut mieux enregistrer avec le CPU throttling activé, pour se rapprocher des conditions d’un smartphone de milieu de gamme.
Sur les utilisateurs réels, Chrome propose la Long Animation Frames API, qui signale les frames pour lesquelles le navigateur a mis plus de 50 millisecondes à mettre à jour l’écran et, contrairement à l’ancienne Long Tasks API, indique quels scripts ont contribué, avec fichier, fonction et durée. C’est l’outil le plus utile pour savoir quels scripts ralentissent les interactions sur les appareils des visiteurs :
new PerformanceObserver( ( list ) => {
	for ( const frame of list.getEntries() ) {
		for ( const script of frame.scripts ) {
			// Fichier, fonction et durée de chaque script concerné
			console.log( script.sourceURL, script.sourceFunctionName, script.duration );
		}
	}
} ).observe( { type: 'long-animation-frame', buffered: true } );
Comment intervenir
Exécuter moins de code
La première intervention est toujours la plus efficace : supprimer le code qui ne sert pas. Des scripts chargés sur toutes les pages mais utilisés seulement sur certaines, des bibliothèques qui pourraient être remplacées par quelques lignes de code natif, des fonctionnalités oubliées. La deuxième consiste à reporter le code qui n’est pas nécessaire tout de suite : scripts non critiques chargés avec defer, widgets démarrés seulement quand l’utilisateur interagit, comme dans la technique du report du JavaScript jusqu’au premier clic.
Découper les longs traitements
Quand le travail est nécessaire, on peut le découper en parties plus petites, en rendant périodiquement la main au navigateur, opération appelée yielding. Entre une partie et la suivante, le navigateur peut traiter les entrées en attente et mettre à jour l’écran. Les versions récentes de Chrome disposent d’une fonction dédiée, scheduler.yield(), qui rend la main puis reprend le travail en priorité, avant d’autres tâches moins importantes ; dans les autres navigateurs, on peut se rabattre sur setTimeout :
function cediIlPasso() {
	if ( globalThis.scheduler?.yield ) {
		return scheduler.yield();
	}
	return new Promise( ( resolve ) => setTimeout( resolve, 0 ) );
}

async function elaboraTutto( elementi ) {
	for ( const elemento of elementi ) {
		elabora( elemento );
		await cediIlPasso(); // laisse le navigateur répondre entre un élément et le suivant
	}
}
Dans les gestionnaires d’événements, le principe est de donner un retour visuel immédiat et de reporter le reste. Si un clic doit mettre à jour l’interface, envoyer un événement analytics et enregistrer des données, il vaut mieux mettre à jour l’interface d’abord, rendre la main pour que le navigateur affiche, et n’exécuter le reste qu’ensuite.
Déplacer le travail ailleurs
Pour les traitements lourds qui ne touchent pas au DOM, comme les calculs, l’analyse de données ou la compression, les Web Workers permettent d’exécuter du JavaScript sur un thread séparé, en laissant le thread principal libre. Pour le travail non urgent, requestIdleCallback l’exécute quand le navigateur n’a rien d’autre à faire. Et pour le rendu, réduire la taille du DOM et utiliser des propriétés comme content-visibility abaisse le coût de chaque recalcul de styles et de mise en page.
Pourquoi le mobile est pire
Le même script peut prendre 40 millisecondes sur un ordinateur récent et 200 sur un smartphone d’entrée de gamme. L’écart de puissance entre les processeurs des appareils les plus répandus et ceux qu’utilisent les développeurs est énorme, et le JavaScript est l’une des activités qui en souffrent le plus. C’est pourquoi un site qui semble parfaitement réactif au bureau peut avoir un mauvais INP dans les données de terrain : les tâches longues qui n’existent pas sur l’ordinateur du développeur apparaissent sur les téléphones de milieu de gamme, qui sont la majorité des visiteurs réels.
C’est aussi la raison pour laquelle Lighthouse, en mode mobile, simule un processeur ralenti, et pour laquelle le TBT mobile est presque toujours bien plus élevé que le TBT desktop. Quand on teste un site à la main, il vaut mieux activer le CPU throttling dans les DevTools, ralenti de quatre ou six fois, ou utiliser un vrai smartphone de milieu de gamme : c’est le moyen le plus rapide de voir la page comme la voit la plupart des utilisateurs.
Le cas de WordPress
Sur les sites WordPress, les tâches longues viennent rarement du cœur de WordPress, et bien plus souvent de ce qu’on y ajoute : thèmes et page builders qui chargent jQuery et des dizaines de scripts sur chaque page, sliders et animations, plugins de statistiques, formulaires, outils de cookies et de marketing. Le panneau Performance, avec les noms de fichiers dans les traces, montre généralement vite quels plugins sont responsables. À partir de là, les pistes sont les mêmes : supprimer, limiter aux pages où ils sont nécessaires, différer.
En bref
Le thread principal est l’ouvrier unique qui exécute le JavaScript, calcule la mise en page, affiche et répond aux utilisateurs. Une tâche longue est un travail qui l’occupe pendant plus de 50 millisecondes, durée pendant laquelle la page ne peut pas réagir. Le Total Blocking Time additionne ces attentes pendant le chargement, en laboratoire, et c’est un bon indicateur, mais la métrique qui compte sur le terrain est l’INP.
Pour s’améliorer, il faut suivre un ordre précis : exécuter moins de code, reporter ce qui n’est pas urgent, découper les longs traitements en rendant la main au navigateur, déplacer les traitements lourds hors du thread principal. Les DevTools et la Long Animation Frames API montrent où intervenir. Il ne faut pas un site sans JavaScript : il faut un JavaScript qui laisse toujours au navigateur un instant pour répondre à celui qui utilise la page.
