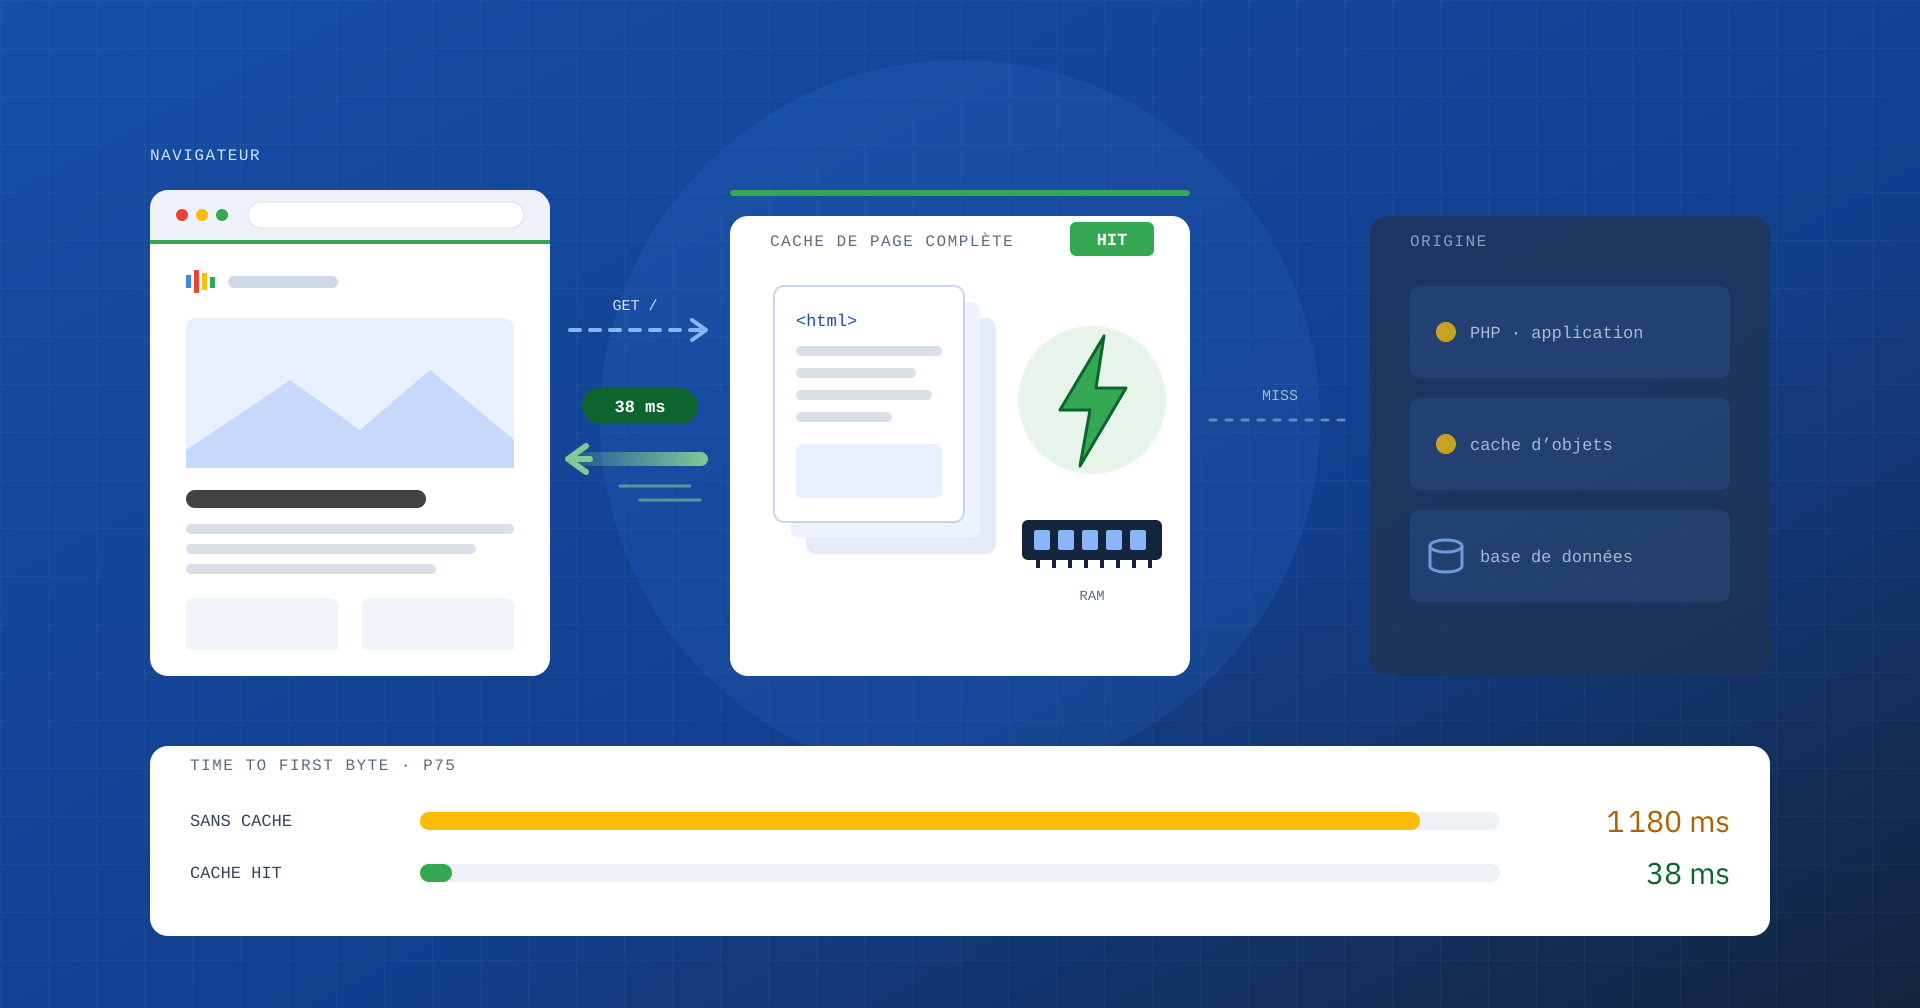
Avant que le navigateur puisse afficher le moindre pixel, il doit recevoir du serveur le premier octet de la page. Le temps qui sépare la requête de ce premier octet a un nom, le TTFB, et c’est le socle sur lequel repose toute autre métrique de vitesse. Si ce socle est lent, aucune optimisation front-end ne peut rendre le site vraiment rapide.
Dans cet article, nous voyons ce que mesure le TTFB, pourquoi il influence directement le LCP et les résultats business, et comment le cache de page, avec Varnish comme référence pour les projets de niveau entreprise, peut le réduire d’un ordre de grandeur. Nous examinons aussi les cas où le cache ne suffit pas.
Ce qu’est le TTFB
Le Time to First Byte mesure l’intervalle entre le début de la navigation et l’arrivée du premier octet de la réponse HTML. Ce n’est pas seulement le « temps serveur » : il comprend les éventuelles redirections, la résolution DNS, l’ouverture de la connexion TCP, la négociation TLS et enfin le temps que met le serveur à traiter la requête et à commencer à répondre.
| Phase | De quoi elle dépend |
|---|---|
| Redirections | Chaînes de redirections, par exemple de http vers https et du domaine sans www vers www |
| DNS | Qualité du fournisseur DNS et durée de vie en cache des enregistrements |
| Connexion et TLS | Distance physique du serveur, protocole (HTTP/2, HTTP/3), configuration TLS |
| Traitement | Cache de page, code applicatif, base de données, ressources du serveur |
À titre de référence, un TTFB de 0,8 seconde maximum au 75e percentile est considéré comme bon, tandis qu’au-delà de 1,8 seconde il faut intervenir en urgence. Le TTFB ne fait pas partie des trois Core Web Vitals, mais c’est une métrique de diagnostic fondamentale : chaque milliseconde passée avant le premier octet s’ajoute au FCP et au LCP, et laisse moins de marge pour tout le reste.
Pourquoi le TTFB compte pour le business
Imaginez un site e-commerce avec un TTFB de 1,5 seconde. Pour rester dans les 2,5 secondes d’un bon LCP, le navigateur n’a plus qu’une seconde pour télécharger les feuilles de style, les polices et l’image principale, et pour dessiner la page. Sur un smartphone avec une connexion mobile moyenne, c’est un objectif presque inatteignable. Le résultat est un LCP médiocre qu’aucun travail sur les images ou le JavaScript ne peut corriger entièrement.
Les conséquences se voient dans les chiffres : plus d’abandons dans les premières phases de la visite, des landing pages de campagne qui gaspillent une partie des clics que vous avez payés, des pages de catégories et de produits qui répondent lentement précisément quand le trafic arrive. Et il y a un effet moins visible mais tout aussi concret : un serveur qui met trop de temps à générer chaque page épuise plus vite ses ressources. Aux moments de pic, comme une promotion, l’envoi d’une newsletter ou un sujet d’actualité qui devient viral, le TTFB ne croît pas de façon linéaire mais explose, jusqu’aux erreurs et aux pannes.
Les moteurs de recherche sont eux aussi touchés : un serveur lent limite le nombre de pages que les robots parviennent à récupérer dans le temps imparti, un problème qui, sur les sites avec de gros catalogues ou de grandes archives, se traduit par une indexation tardive des contenus.
Le cache de page : le principe
Dans un CMS comme WordPress, WooCommerce, Magento ou Joomla, chaque page est normalement construite à la volée : le serveur exécute le code PHP, interroge la base de données, assemble les modèles et les contenus, et n’envoie le HTML qu’à la fin. C’est un travail qui peut prendre des centaines de millisecondes ou quelques secondes, et qui se répète à l’identique pour chaque visiteur.
Le cache de page, ou Full Page Cache, part d’un constat simple : pour la grande majorité des visites, le HTML généré est le même. Il est donc logique de le générer une fois, de le conserver et de servir la copie prête aux requêtes suivantes. Quand la page demandée est dans le cache, on parle de HIT et la réponse part en quelques millisecondes ; quand elle n’y est pas, on parle de MISS et la requête se poursuit jusqu’à l’application, qui génère la page et la remet au cache pour la fois suivante.
Deux paramètres déterminent l’efficacité d’un cache : le taux de HIT, c’est-à-dire le pourcentage de requêtes servies sans solliciter l’application, et la stratégie d’invalidation, c’est-à-dire la façon dont une page est mise à jour quand son contenu change. Un cache avec un faible taux de HIT, ou qui sert des contenus périmés, est respectivement inutile ou nuisible.
Varnish, le standard entreprise pour le Full Page Cache
Parmi les solutions disponibles, Varnish Cache est depuis des années le premier choix pour les projets de niveau entreprise : grands éditeurs de presse, sites e-commerce aux catalogues étendus, portails aux pics de trafic imprévisibles. C’est un reverse proxy HTTP placé devant le serveur web, qui conserve les pages directement en RAM et répond sans toucher ni à PHP ni à la base de données. Sur un matériel adapté, il sert des dizaines de milliers de requêtes par seconde avec des temps de réponse de quelques millisecondes.
Les raisons de son succès ne tiennent cependant pas seulement à la vitesse :
- VCL, un vrai langage de configuration. Le Varnish Configuration Language permet de décider, requête par requête, ce qu’il faut mettre en cache, pour combien de temps, quels cookies ignorer et quels paramètres d’URL normaliser. C’est la différence entre un cache générique et un cache conçu autour de l’application.
- Une invalidation précise. Avec PURGE et BAN, on peut retirer une seule page ou des groupes entiers de pages au moment où le contenu change, par exemple quand un prix est mis à jour ou qu’un article est publié, sans vider tout le cache.
- Le grace mode. Quand une page expire, Varnish peut continuer à servir la copie précédente pendant qu’il en demande une nouvelle en arrière-plan. Si l’application est lente ou momentanément injoignable, les utilisateurs continuent de recevoir des pages rapides au lieu d’une erreur.
- La protection contre les pics. Plusieurs requêtes simultanées pour une même page pas encore en cache sont fusionnées en une seule requête vers l’application, ce qui évite qu’un pic de trafic ne se transforme en centaines de calculs identiques.
- ESI (Edge Side Includes). Une page peut être composée de fragments aux règles de cache différentes : une partie personnalisée n’empêche donc pas de mettre tout le reste en cache.
Il faut savoir que la version open source de Varnish ne gère pas directement le HTTPS : en production, on l’associe à un terminateur TLS, comme Nginx ou Hitch, qui reçoit les connexions chiffrées et les transmet à Varnish. C’est une architecture éprouvée, mais elle doit être conçue et maintenue par des personnes qui connaissent bien les deux composants.
Les alternatives et quand elles ont du sens
Varnish n’est pas la seule voie, et ce n’est pas toujours la meilleure. Il y a trois options principales :
- Les plugins de cache du CMS. Ils enregistrent les pages sur disque et les servent via PHP ou des règles du serveur web. Ils sont simples à activer et adaptés aux petits sites, mais la requête traverse encore une partie de la pile et les règles d’exclusion sont souvent génériques.
- Le cache du serveur web, comme le FastCGI cache de Nginx. Plus efficace que les plugins et sans composant supplémentaire, mais avec des outils d’invalidation et une logique conditionnelle moins riches que VCL.
- Le cache de CDN. Il rapproche les pages des utilisateurs, ce qui réduit aussi la latence réseau. C’est un excellent complément pour un public international, à condition de gérer avec soin l’invalidation et les contenus personnalisés. La configuration la plus robuste associe souvent un CDN à Varnish à l’origine.
Quand le cache ne suffit pas
Le cache de page corrige le TTFB pour les visites anonymes, mais toutes les visites ne le sont pas. Les utilisateurs connectés, ceux qui ont des produits dans leur panier, ceux qui finalisent une commande reçoivent des pages personnalisées qui ne peuvent pas être partagées. Sur un site e-commerce, ce sont précisément les personnes les plus proches de l’achat.
Il y a ensuite des erreurs de configuration très courantes qui abaissent le taux de HIT sans que personne ne s’en aperçoive : un cookie posé pour tous les visiteurs qui leur fait contourner le cache, des paramètres de campagne comme utm_source ou gclid qui créent une copie différente de la même page à chaque clic, des durées d’expiration trop courtes, des invalidations qui vident tout le cache à chaque modification.
C’est pourquoi le chemin « MISS » doit être aussi rapide que le chemin « HIT » est instantané. Cela suppose de travailler sur l’origine : une version récente de PHP avec un OPcache correctement dimensionné, un cache d’objets persistant comme Redis pour éviter les requêtes répétées, une base de données optimisée et nettoyée des options chargées à chaque requête, des sessions et des données temporaires accumulées au fil des ans, et une application qui ne fait pas de travail inutile à chaque page.
Comment le mesurer
Le TTFB réel des utilisateurs est disponible dans le Chrome UX Report, aussi bien pour l’ensemble de l’origine que pour les pages individuelles qui ont assez de trafic. Pour le diagnostic, en revanche, il faut observer les réponses une à une. Un premier contrôle tient en une seule ligne de commande :
curl -s -o /dev/null -w "DNS %{time_namelookup}s · TLS %{time_appconnect}s · TTFB %{time_starttransfer}s\n" https://www.votresite.fr/En répétant la requête plusieurs fois, on voit tout de suite la différence entre la première réponse, souvent un MISS, et les suivantes servies depuis le cache. Les en-têtes de réponse comme X-Cache ou Age indiquent si la page vient du cache et depuis combien de temps elle y est, tandis que l’en-tête Server-Timing permet à l’application de déclarer le temps passé dans chaque phase. Côté serveur, des outils comme varnishstat et varnishlog montrent le taux de HIT global et la raison de chaque MISS.
En résumé
Le TTFB est le point de départ de chaque page : s’il est lent, toutes les métriques suivantes le sont aussi. Le cache de page est l’outil le plus efficace pour le réduire, et Varnish, avec son stockage en mémoire, sa logique configurable et sa gestion des pics, est la solution de référence quand le trafic et la valeur des pages sont élevés. Mais un cache ne fonctionne vraiment que s’il est conçu autour de l’application, avec des règles d’exclusion et d’invalidation précises, et si le chemin sans cache reste rapide.
C’est un travail qui associe administration système et développement : c’est pourquoi nous l’abordons toujours en regardant ensemble le serveur et l’application, et en vérifiant les résultats sur des données d’utilisateurs réels, pas sur un seul test.
