Chaque site a ses jours décisifs. Pour une boutique en ligne, ce sont le Black Friday, les soldes, la période de Noël. Pour une entreprise, ce peut être le lancement d’un produit, un passage à la télévision, une campagne publicitaire, une newsletter envoyée à cent mille abonnés. À ces moments-là, des semaines de trafic arrivent en quelques heures, et elles arrivent exactement quand chaque visite vaut le plus. C’est aussi le moment où de nombreux sites ralentissent, renvoient des erreurs ou cessent complètement de fonctionner.
La performance sous charge est un aspect de la performance web que les tests habituels ne mesurent pas : PageSpeed Insights et Lighthouse chargent une page à la fois, dans des conditions calmes. Dans cet article, nous voyons ce qui arrive à un site quand le trafic se multiplie, comment estimer ce qu’il peut encaisser, comment le vérifier avec un test de charge et comment le préparer aux pics.
Ce qui se passe quand le trafic augmente
Pour comprendre comment un site se comporte sous charge, il faut distinguer deux types de requêtes. Les pages servies depuis le cache de page, comme la page d’accueil, les catégories et les fiches produit pour les visiteurs anonymes, demandent très peu de ressources : le serveur web renvoie un fichier tout prêt, et un serveur moderne peut le faire des milliers de fois par seconde. Les pages dynamiques, comme le panier, le tunnel de commande, l’espace client, la recherche et les appels AJAX, doivent être générées par PHP et la base de données à chaque requête.
Les requêtes dynamiques sont traitées par un nombre limité de processus PHP, souvent appelés workers PHP. Chaque processus traite une requête à la fois : si un site a huit processus et que chaque requête dynamique prend 400 millisecondes, il peut en traiter au maximum une vingtaine par seconde. Quand il en arrive davantage, les requêtes en excès attendent dans une file. Le temps passé dans la file s’ajoute au temps de réponse, et donc au TTFB que vit l’utilisateur.
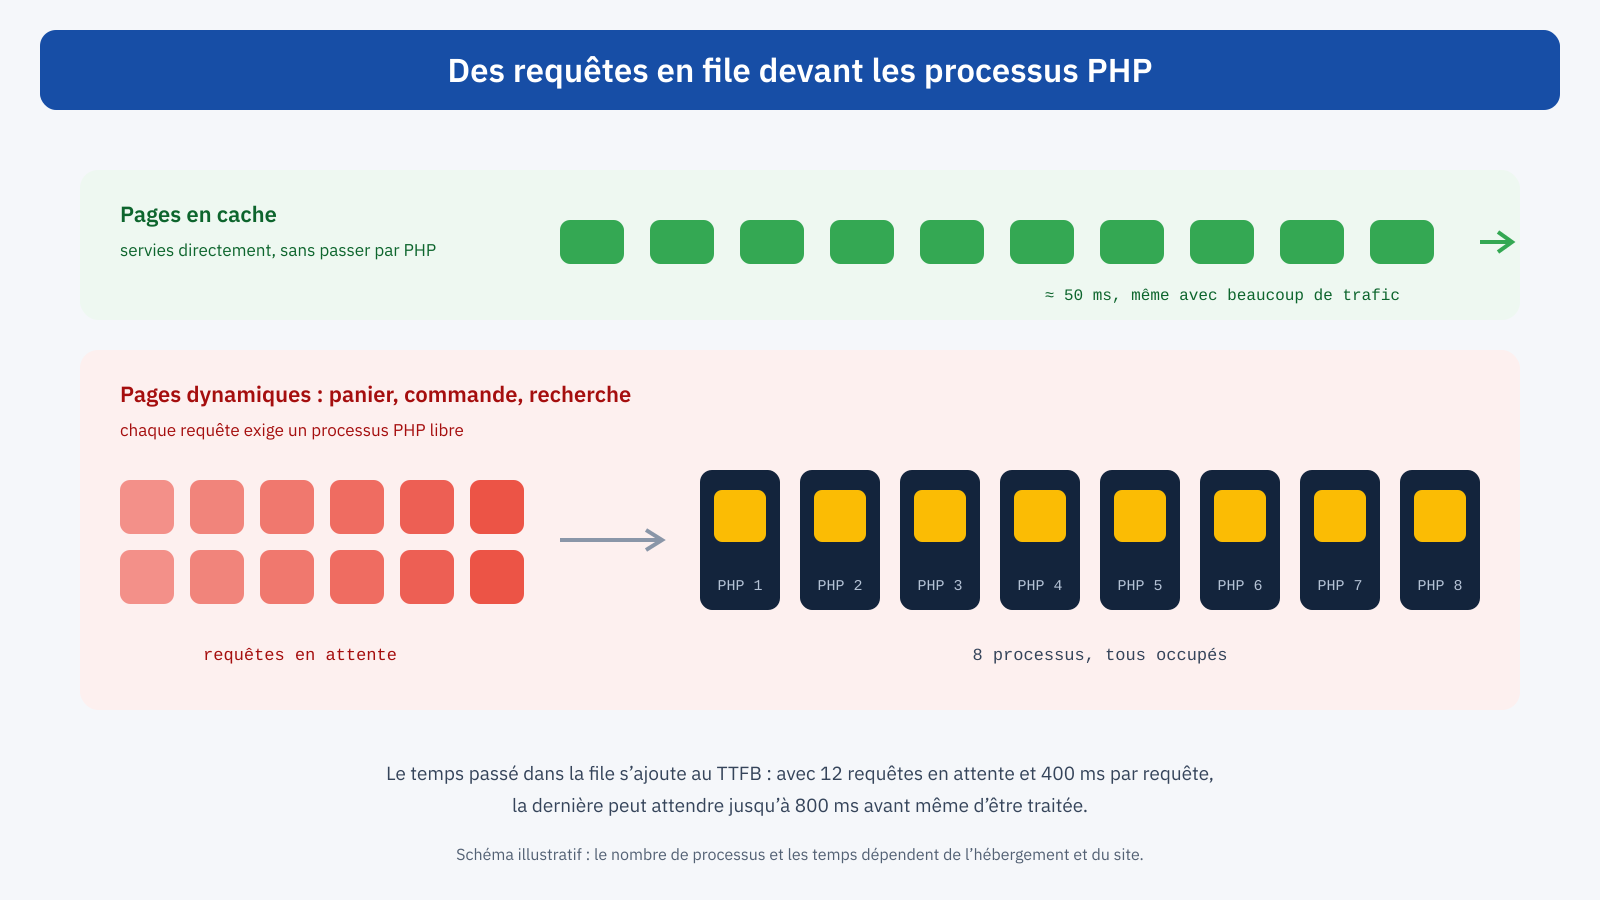
Le comportement est fortement non linéaire. Tant que les requêtes arrivent plus lentement que le serveur ne peut les traiter, les temps restent stables. Dès que le rythme dépasse ce seuil, la file s’allonge chaque seconde, les temps montent vite et, au-delà d’un certain point, les requêtes expirent et le serveur répond par des erreurs, comme les codes 502 ou 504. Pour aggraver les choses, les requêtes lentes retiennent les processus plus longtemps et les utilisateurs impatients rechargent la page, ajoutant des requêtes à la file.
Pour les métriques, le résultat est un TTFB qui explose précisément sur les pages du parcours d’achat. Dans les données de terrain du Chrome UX Report, moyennées sur 28 jours, un pic d’une journée se remarque à peine. Mais l’effet économique se concentre sur ces heures : paniers abandonnés, paiements non finalisés, clients qui partent chez la concurrence, comme nous l’avons vu dans l’article sur les Core Web Vitals pour WooCommerce.
Estimer la capacité
Une première estimation de la capacité d’un site peut se faire par un calcul simple : le nombre de processus PHP divisé par le temps moyen de traitement d’une requête dynamique, en secondes, donne le nombre maximal de requêtes dynamiques par seconde. Avec 8 processus et 0,4 seconde par requête, la limite est de 20 requêtes par seconde. Il faut ensuite estimer combien de requêtes dynamiques un utilisateur génère : une visite du panier peut en produire plusieurs, entre la page elle-même, les appels AJAX qui mettent à jour les quantités et la livraison, le mini-panier dans l’en-tête, et d’éventuelles requêtes périodiques du plugin de chat ou de l’administration de WordPress.
Le calcul est approximatif, mais il montre tout de suite les deux principaux leviers pour augmenter la capacité : plus de processus, c’est-à-dire plus de ressources sur le serveur, ou des requêtes plus rapides, c’est-à-dire un code et une base de données plus efficaces. Diviser par deux le temps de traitement d’une requête équivaut à doubler les processus, et coûte souvent beaucoup moins cher.
Le test de charge
L’estimation doit être vérifiée par un test de charge : un outil qui simule de nombreux utilisateurs simultanés et mesure les temps de réponse et les erreurs à mesure que le trafic augmente. Il existe des outils open source, comme k6, Locust et JMeter, et des services qui exécutent les tests depuis des serveurs distribués. Un test utile présente quelques caractéristiques précises.
- Un environnement représentatif. Idéalement une copie du site de production, sur la même infrastructure, avec des données réalistes. Tester directement la production est possible, mais il faut le faire à des heures de faible trafic et avec prudence, en prévenant l’hébergeur.
- Des scénarios réalistes. Pas seulement la page d’accueil répétée des milliers de fois, qui mesure surtout le cache, mais des parcours typiques : parcourir les catégories et les produits, ajouter au panier, rechercher, commencer le tunnel de commande, dans les proportions observées dans les analytics.
- Une charge croissante. Les utilisateurs simulés augmentent progressivement, pour trouver le point où les temps cessent d’être stables.
- Les bonnes métriques. Le temps de réponse au 95e percentile, pas seulement la moyenne, et le taux d’erreurs, observés avec l’utilisation du CPU, de la mémoire et de la base de données sur le serveur.
// Scénario k6 : navigation et panier avec une charge croissante
import http from 'k6/http';
import { sleep, check } from 'k6';

export const options = {
	stages: [
		{ duration: '2m', target: 100 },
		{ duration: '4m', target: 300 },
		{ duration: '4m', target: 500 },
	],
	thresholds: {
		http_req_duration: [ 'p(95)<800' ],
		http_req_failed: [ 'rate<0.01' ],
	},
};

export default function () {
	http.get( 'https://staging.esempio.it/categoria/scarpe/' );
	sleep( 2 );
	http.get( 'https://staging.esempio.it/prodotto/scarpa-trail/' );
	sleep( 3 );
	const r = http.post( 'https://staging.esempio.it/?wc-ajax=add_to_cart', { product_id: 128, quantity: 1 } );
	check( r, { 'ajouté au panier': ( res ) => res.status === 200 } );
	http.get( 'https://staging.esempio.it/carrello/' );
	sleep( 4 );
}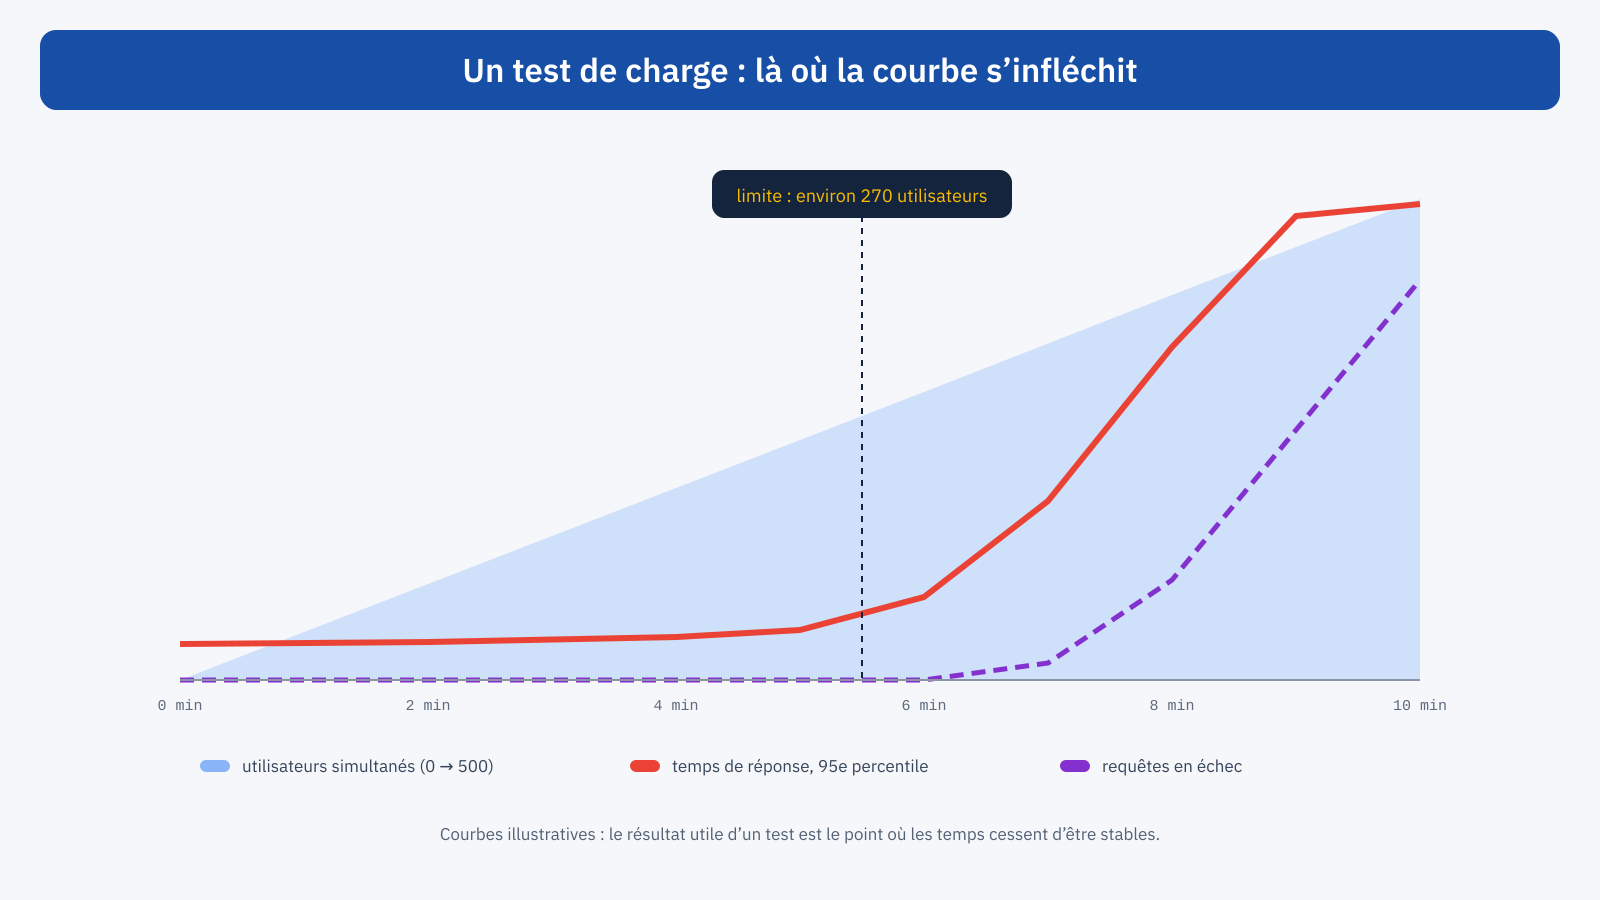
Le résultat à chercher est le point de rupture : le nombre d’utilisateurs au-delà duquel les temps cessent d’être stables. Comparé au trafic attendu au pic, il indique si le site est prêt et avec quelle marge. Répété après chaque intervention, il mesure l’effet des optimisations. Il vaut aussi la peine d’observer quelle ressource s’épuise en premier : processus PHP, CPU, mémoire, connexions à la base de données. C’est là qu’il faut concentrer le travail.
Préparer le site : réduire le travail dynamique
La stratégie la plus efficace pour résister à un pic est de faire en sorte que la plupart des requêtes n’atteignent jamais PHP. Quelques mesures ont un impact énorme.
- Maximiser le cache de page. Vérifiez que chaque page qui peut être mise en cache l’est, même pour les personnes qui ont des produits dans leur panier lorsque la configuration le permet, et réchauffez le cache avant le pic en visitant les pages principales, pour que les premiers visiteurs ne trouvent pas un cache vide.
- Éliminer les requêtes superflues. Les appels AJAX qui se déclenchent sur chaque page, comme les fragments du panier, le heartbeat de l’administration de WordPress, les compteurs et les widgets qui interrogent le serveur périodiquement, multiplient la charge par le nombre de visiteurs. Chacun doit être justifié ou supprimé.
- Accélérer les requêtes dynamiques. Un cache d’objets réduit les requêtes à la base de données ; une analyse des requêtes les plus lentes, des index manquants et des plugins les plus lourds raccourcit le temps de traitement de chaque requête.
- Déplacer le travail loin du moment critique. E-mails de confirmation envoyés via une file d’attente, opérations planifiées lourdes comme les imports, les synchronisations et la génération de rapports suspendues pendant le pic, cron de WordPress exécuté par le système plutôt que par les visites.
- Décharger le contenu statique. Les images, feuilles de style et scripts servis depuis un CDN n’occupent pas le serveur d’origine.
Préparer l’infrastructure
Une fois le site optimisé, il reste la capacité du serveur. De nombreux hébergeurs permettent d’augmenter temporairement les ressources, processus PHP, CPU et mémoire, pour la durée du pic : demandez bien à l’avance, pas le matin du Black Friday. Les infrastructures cloud peuvent s’adapter automatiquement, mais cette montée en charge doit être configurée et vérifiée par un test, car le démarrage de nouvelles instances prend du temps et la base de données reste souvent un point de contention unique. La comparaison entre les modèles d’hébergement se trouve dans l’article sur l’hébergement et les Core Web Vitals.
Pour les pics extrêmes et imprévisibles, comme un passage à la télévision, il existe aussi la solution de la salle d’attente virtuelle : quand le trafic dépasse la capacité, les nouveaux visiteurs sont placés dans une file sur une page statique et admis progressivement. Ce n’est pas élégant, mais c’est bien mieux qu’un site qui cesse de répondre pour tout le monde.
Un exemple de préparation
Une boutique de vêtements attend pour le Black Friday un trafic huit fois supérieur à la moyenne, avec une newsletter envoyée à neuf heures du matin. Le test de charge sur l’environnement de préproduction montre le point de rupture à environ 150 utilisateurs simultanés, contre les 600 attendus au pic. L’analyse montre que la moitié des requêtes dynamiques sont des appels AJAX venant du mini-panier et d’un widget de notification d’achats, et que les pages du panier prennent 900 millisecondes à cause d’un plugin de calcul des frais de livraison qui interroge un service externe à chaque chargement.
Le plan consiste à supprimer le widget de notification, à remplacer le mini-panier par une version qui n’interroge pas le serveur à chaque page, à conserver quelques minutes les résultats du calcul de livraison, à activer le cache d’objets et à doubler temporairement les processus PHP avec l’hébergeur. Le nouveau test repousse le point de rupture au-delà de 700 utilisateurs. Le jour du Black Friday, le TTFB du panier reste sous 500 millisecondes même à l’heure de pointe, et le monitoring n’enregistre aucune erreur.
Le jour du pic
Quelques règles de conduite réduisent le risque aux heures critiques. Pas de mise en production, pas de mises à jour de plugins et pas de modifications de configuration dans les jours qui précèdent immédiatement le pic et pendant celui-ci : chaque changement introduit un risque, et le pire moment pour découvrir un problème est celui où le site est sous charge maximale. Un monitoring actif, avec des alertes sur les temps de réponse, les erreurs et l’utilisation des ressources, permet d’intervenir avant que les utilisateurs ne s’en aperçoivent. Et un plan d’urgence écrit, indiquant qui fait quoi, quelles fonctionnalités désactiver en premier et comment contacter l’hébergeur, évite les décisions improvisées.
Parmi les fonctionnalités qu’il faut pouvoir désactiver rapidement en cas de surcharge figurent les plus coûteuses et non essentielles : la recherche avec suggestions en temps réel, les filtres avancés du catalogue, les produits recommandés calculés à la volée, le chat, les widgets tiers. Prévoir à l’avance comment les éteindre, par exemple avec un réglage dans l’administration, permet de protéger le parcours d’achat quand c’est nécessaire.
Après le pic
Le lendemain est le meilleur moment pour apprendre. Les journaux du serveur et de l’hébergeur montrent les pics de requêtes, les temps de réponse et les éventuelles erreurs ; les analytics montrent où les utilisateurs sont partis ; un système de Real User Monitoring montre comment les métriques se sont comportées heure par heure. Comparer ces données avec les résultats du test de charge permet de savoir si le test était réaliste et où intervenir avant le prochain événement.
En résumé
Sous charge, un site se comporte différemment de ce que montrent les tests habituels. Les pages en cache résistent à presque n’importe quel trafic ; les requêtes dynamiques font la queue devant un nombre limité de processus PHP, et au-delà d’un certain point les temps explosent et des erreurs apparaissent, sur les pages du parcours d’achat et aux moments précis où chaque visite vaut le plus.
Se préparer, c’est estimer la capacité, la vérifier avec un test de charge réaliste, réduire le travail dynamique grâce au cache, supprimer les requêtes superflues et optimiser les requêtes à la base de données, augmenter temporairement les ressources si nécessaire, et aborder le jour du pic avec un monitoring, sans aucune modification et avec un plan d’urgence. C’est un travail réalisé des semaines à l’avance, qui se rentabilise en quelques heures.
