Pendant des années, l’optimisation du CSS a surtout concerné le poids des feuilles de style et leur mode de chargement : supprimer les règles inutilisées, extraire le CSS critique, empêcher une feuille de style de bloquer le premier rendu. Ce sont toujours des sujets centraux. Mais ces dernières années, le CSS s’est aussi doté d’outils qui agissent sur le travail du navigateur après le chargement : des propriétés qui permettent d’ignorer le rendu de ce qui n’est pas visible, de limiter le recalcul à une partie de la page et d’adapter les composants sans recourir à JavaScript.
Dans cet article, nous voyons les trois plus utiles pour la performance, content-visibility, contain et les container queries, ainsi que d’autres fonctionnalités modernes qui permettent de supprimer des scripts, avec des conseils sur où les utiliser, où les éviter et comment vérifier qu’elles sont vraiment nécessaires.
Le travail du navigateur sur les pages longues
Comme nous l’avons vu avec le chemin critique de rendu, après avoir téléchargé le HTML et le CSS, le navigateur calcule les styles de chaque élément, détermine sa position et sa taille, et peint la page. Par défaut, il le fait pour toute la page, même pour les parties que l’utilisateur ne verra qu’après un long défilement, ou qu’il ne verra jamais. Sur une page courte, la différence est négligeable. Sur un long article avec des centaines de commentaires, sur une page de catégorie avec des dizaines de fiches produit, sur une page construite avec un page builder qui génère des milliers d’éléments, le rendu initial peut occuper pendant des centaines de millisecondes le thread principal d’un smartphone.
Ce travail retarde le premier rendu et, surtout, il se répète : chaque fois que quelque chose modifie la mise en page, le navigateur doit vérifier quels éléments sont concernés, et plus la page est grande, plus la vérification coûte cher. C’est l’une des raisons pour lesquelles les interactions sur des pages très longues ont tendance à avoir un moins bon INP.
content-visibility : ignorer ce qu’on ne voit pas
La propriété content-visibility avec la valeur auto indique au navigateur que le contenu d’un élément peut être ignoré tant que l’élément est loin de l’écran. Le navigateur ne calcule ni la mise en page ni le rendu de ses enfants ; il les traite quand l’élément s’approche de la zone visible pendant le défilement. Le contenu reste dans le document : il est accessible aux lecteurs d’écran, peut être trouvé avec la recherche du navigateur, peut être atteint par des liens internes. Seul change le moment où le navigateur s’en occupe.
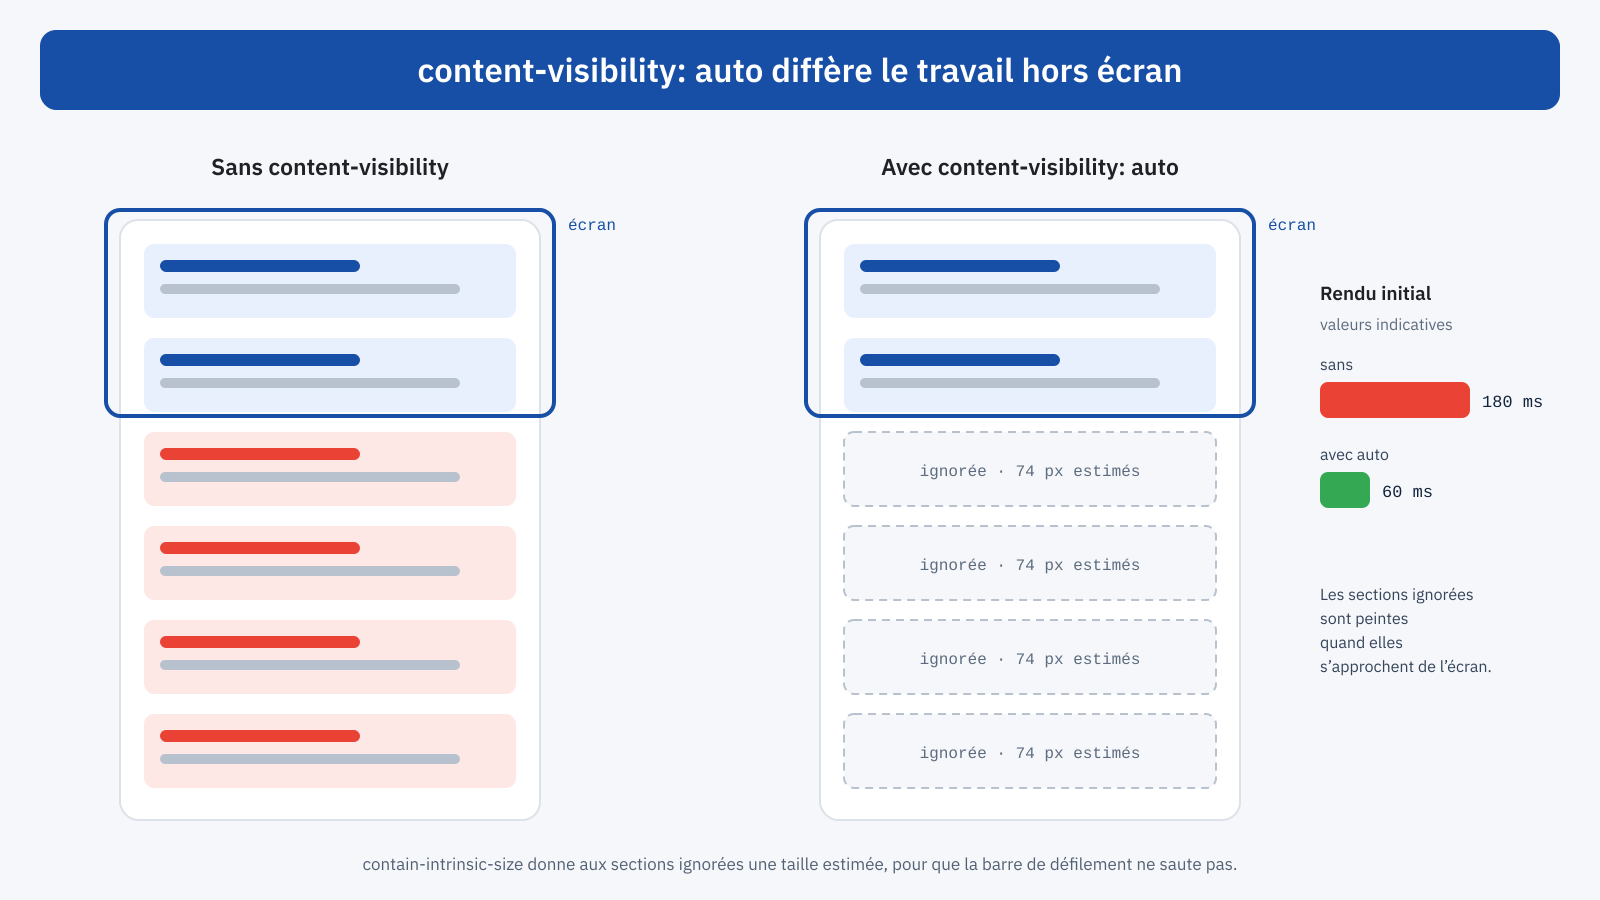
Il y a un détail important. Tant que le contenu n’est pas traité, le navigateur ne connaît pas sa hauteur, et traiterait l’élément comme s’il avait une hauteur nulle. La page serait plus courte qu’elle ne l’est vraiment et la barre de défilement sauterait à mesure que les sections sont traitées. Pour l’éviter, on utilise contain-intrinsic-size, qui fournit une taille estimée. Avec le mot-clé auto, le navigateur retient la taille réelle après le premier traitement et l’utilise à la place de l’estimation.
/* Commentaires et sections en bas de l’article */
.commentlist > li,
.articoli-correlati,
.site-footer {
	content-visibility: auto;
	contain-intrinsic-size: auto 600px;
}
L’estimation n’a pas besoin d’être précise, mais elle doit être raisonnable : si elle est loin de la réalité, la longueur de la page change sensiblement pendant le défilement. Dans la plupart des cas, ce n’est pas un problème pour le CLS, car les décalages se produisent hors écran, mais cela peut rendre le défilement moins prévisible, surtout quand on fait glisser la barre de défilement.
Où l’utiliser et où ne pas l’utiliser
content-visibility: auto est rentable quand il y a beaucoup de contenu hors écran et que ce contenu est complexe. Les candidats typiques sont les listes de commentaires, les sections d’articles liés, les longues pages de catégorie ou d’archive, les footers riches, les fiches produit en bas de page, les tableaux de caractéristiques. Dans ces cas, l’économie sur le rendu initial peut être significative.
Il faut en revanche l’éviter sur les éléments visibles au chargement, et en particulier sur ceux qui contiennent l’élément du LCP : il n’y a rien à différer, et cela ne fait qu’ajouter une étape. Il est peu utile sur les éléments petits et simples, où le coût évité est minime, et il doit être appliqué avec prudence aux éléments dont le contenu est mesuré par des scripts, comme certains carrousels ou galeries, qui pourraient lire de mauvaises tailles tant que le contenu n’est pas traité. Une dernière précaution concerne les ancres : sauter avec un lien interne vers une section éloignée fonctionne, mais les sections intermédiaires sont traitées avec la taille estimée, et la position finale peut se décaler légèrement si les estimations sont imprécises.
contain : confiner le recalcul
La propriété contain est l’outil sur lequel repose content-visibility, et elle peut aussi s’utiliser seule. Elle déclare au navigateur qu’un élément est indépendant du reste de la page sous un ou plusieurs aspects, et lui permet de limiter le travail quand quelque chose change à l’intérieur. Il y a quatre valeurs principales :
layout: la mise en page interne de l’élément n’affecte pas la mise en page externe, et inversement ;paint: le contenu n’est pas peint en dehors des bordures de l’élément, et si l’élément est hors écran son contenu n’a pas besoin d’être peint ;size: la taille de l’élément ne dépend pas de son contenu, et doit donc être indiquée explicitement ;style: certains effets, comme les compteurs, ne sortent pas de l’élément.
La valeur content équivaut à layout paint style et c’est la plus commode en pratique : elle n’impose pas de fixer la taille et donne au navigateur les garanties les plus utiles. La valeur strict ajoute aussi size, et ne convient qu’aux éléments de dimensions connues, comme un emplacement publicitaire ou un conteneur de widget de taille fixe.
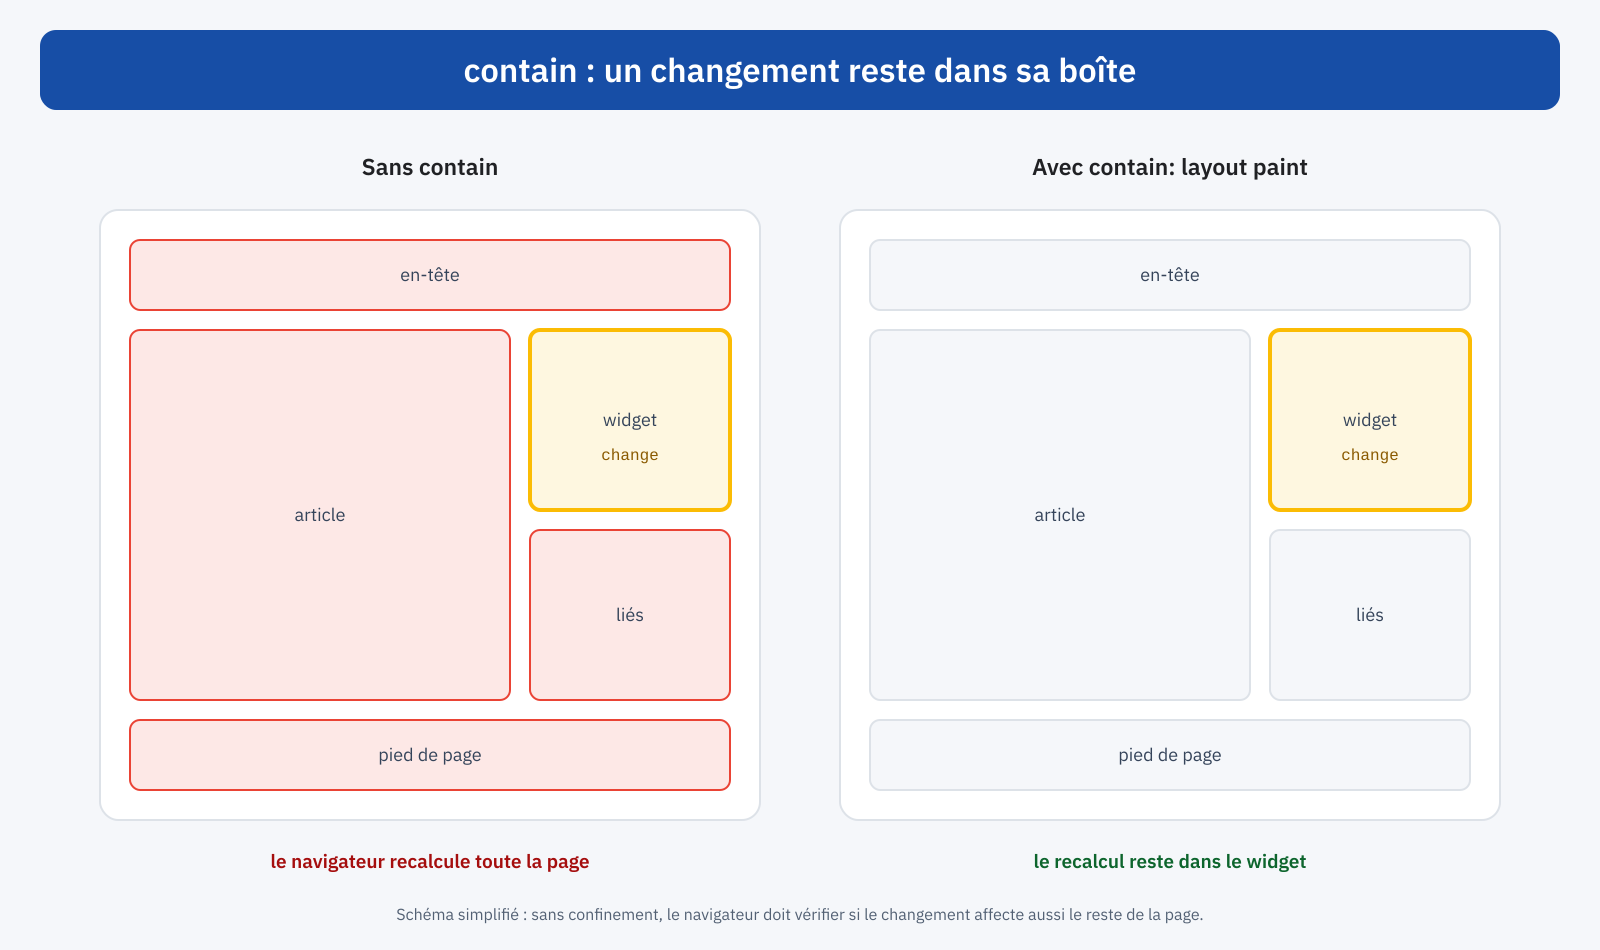
Les cas d’usage les plus intéressants sont les composants qui changent souvent : un widget qui se met à jour périodiquement, un compteur, un panier latéral, un bloc de chat, un panneau de filtres qui affiche et masque des options. Sans confinement, chaque changement à l’intérieur peut obliger le navigateur à recalculer la mise en page d’une grande partie de la page. Avec contain: content, le travail reste confiné. C’est un gain qui se voit surtout dans les interactions, c’est-à-dire dans l’INP, sur les grandes pages.
Le confinement a des effets secondaires qu’il faut connaître. Avec paint, le contenu qui dépasse des bordures est coupé, ce qui peut masquer des menus déroulants, des suggestions ou des ombres qui débordent de la boîte. Avec layout, l’élément devient la référence pour les éléments positionnés qu’il contient, ce qui peut changer la position des éléments en position fixe ou absolue. C’est pourquoi il faut l’appliquer composant par composant, en vérifiant le résultat, et non de façon systématique.
Container queries : des composants adaptatifs sans scripts
Les media queries adaptent le style à la largeur de la fenêtre. Les container queries l’adaptent à la largeur du conteneur dans lequel se trouve un composant. La même fiche produit peut apparaître à l’horizontale dans la colonne principale et à la verticale dans une barre latérale étroite, sans classes différentes ni code qui mesure l’espace disponible.
.griglia-prodotti { container-type: inline-size; }

.scheda { display: grid; gap: 1rem; }

@container ( min-width: 36rem ) {
	.scheda { grid-template-columns: 12rem 1fr; }
}
Les container queries sont avant tout un outil de design, mais elles ont un effet sur la performance : elles remplacent des solutions JavaScript qui mesuraient les conteneurs avec ResizeObserver ou, pire, avec des gestionnaires de l’événement resize, et ajoutaient des classes en conséquence. Ces solutions exécutaient du code sur le thread principal, et provoquaient souvent un premier rendu avec le mauvais style suivi d’une correction, avec un décalage visible. Avec les container queries, l’adaptation se fait au calcul des styles, dès le premier rendu.
Notez que container-type: inline-size applique un confinement de la taille horizontale : la largeur du conteneur ne peut pas dépendre de son contenu. Dans la plupart des mises en page, ce n’est pas un problème, car les conteneurs prennent leur largeur de leur parent, mais un conteneur qui devait s’ajuster à son contenu peut rétrécir de façon inattendue.
Le CSS qui remplace JavaScript
De nombreuses fonctionnalités qui exigeaient autrefois des bibliothèques JavaScript sont désormais disponibles en CSS ou en HTML natif. Chaque script supprimé, c’est moins de code à télécharger, à analyser et à exécuter, et moins de travail sur le thread principal pendant les interactions :
- carrousels : le scroll snapping permet de construire des carrousels défilables avec des arrêts précis sur chaque carte, sans bibliothèques ;
- accordéons et FAQ : l’élément
detailsavecsummaryouvre et ferme le contenu sans scripts ; - fenêtres modales et menus contextuels : l’élément
dialoget l’attributpopovergèrent l’ouverture, la fermeture, le niveau d’empilement et la touche Échap ; - en-têtes collants :
position: stickyremplace les scripts qui écoutaient le défilement pour fixer un élément ; - proportions :
aspect-ratioréserve l’espace des images, vidéos et embeds, en évitant les décalages de mise en page ; - styles conditionnels : le sélecteur
:has()permet de styler un élément selon son contenu, une opération qui exigeait autrefois des scripts ; - animations au défilement : comme on l’a vu dans l’article sur les animations performantes, elles peuvent être déclarées en CSS.
Ce ne sont pas tous des remplacements parfaits : une bibliothèque de carrousel offre des fonctions que le scroll snapping n’a pas, comme la lecture automatique. Mais sur beaucoup de sites ces fonctions ne sont pas nécessaires, et la bibliothèque pèse des dizaines de kilo-octets pour obtenir un effet que le navigateur fournit déjà.
Et les sélecteurs ?
Une question fréquente concerne le coût des sélecteurs complexes. Sur l’immense majorité des sites, il est négligeable : les moteurs des navigateurs sont très optimisés, et le temps passé à évaluer les sélecteurs est une infime fraction du rendu. Il ne devient pertinent que dans des cas extrêmes, avec des DOM très volumineux, des feuilles de style de milliers de règles et des changements fréquents. Le sélecteur :has() mérite un peu d’attention, car une règle comme body:has(.qualcosa) oblige le navigateur à réévaluer le style d’une grande partie de la page à chaque changement de contenu ; limiter sa portée au composant concerné est une bonne habitude. En général, cependant, le poids du CSS inutilisé et la taille du DOM comptent bien plus que la forme des sélecteurs.
Compatibilité et amélioration progressive
Les propriétés décrites sont prises en charge par les versions récentes de tous les grands navigateurs : les container queries et contain depuis un certain temps, content-visibility plus récemment aussi dans Firefox et Safari. L’avantage de ces propriétés est que les navigateurs qui ne les connaissent pas les ignorent : la page fonctionne quand même, simplement sans l’optimisation. C’est un cas idéal d’amélioration progressive (progressive enhancement), qui n’exige ni solution de repli ni code de compatibilité, à la seule exception des container queries, qui changent l’aspect des composants et demandent donc un style de base acceptable même sans elles.
Dans WordPress
Sur un site WordPress, ces règles s’ajoutent dans le CSS du thème enfant ou, dans les thèmes de blocs, dans le CSS additionnel de l’éditeur de site. Les cibles naturelles sont les sections que le thème génère en bas de page : la liste des commentaires, les blocs d’articles liés, le footer, les blocs de requête sur les pages d’archive. Il est plus efficace d’appliquer content-visibility aux éléments individuels d’une longue liste, comme chaque commentaire, qu’à la liste entière, car le navigateur peut alors ne traiter que ceux qui s’approchent de l’écran. Évitez de l’appliquer à tous les blocs du contenu de l’article, qui comprend presque toujours l’élément du LCP et les premières sections visibles.
Comment mesurer
Comme pour toute optimisation, il faut mesurer avant et après. Dans le panneau Performance des DevTools, en enregistrant le chargement de la page avec la limitation du processeur, on compare le temps passé en recalcul des styles, layout et paint. En enregistrant une interaction, comme l’ouverture d’un menu ou la mise à jour d’un filtre, on vérifie si le confinement réduit le travail. Sur les données d’utilisateurs réels, une modification efficace se voit dans le temps de rendu initial et dans l’INP des pages longues, plus que dans les scores de laboratoire, qui sur les pages courtes peuvent ne montrer aucune différence.
Un exemple concret
Prenons un blog aux articles très commentés : certaines pages comptent plus de trois cents commentaires, chacun avec un avatar, un texte et des boutons de réponse, suivis d’un bloc d’articles liés et d’un footer avec plusieurs widgets. Sur un smartphone d’entrée de gamme, le rendu initial de ces pages occupe le thread principal pendant plusieurs centaines de millisecondes, et l’ouverture du menu de navigation répond avec un retard. En appliquant content-visibility: auto aux commentaires individuels, avec une taille estimée raisonnable, et au bloc d’articles liés, le navigateur ne traite que le contenu proche de l’écran ; en ajoutant contain: content au menu, son ouverture n’implique plus le reste de la page. Le contenu reste identique, et la modification tient en quelques lignes de CSS.
En bref
Le CSS moderne offre des outils qui réduisent le travail du navigateur après le chargement. content-visibility: auto diffère le traitement du contenu hors écran et est efficace sur les pages longues, à condition de fournir une taille estimée et de ne pas l’appliquer au contenu visible au chargement. contain confine le recalcul à l’intérieur des composants qui changent souvent, avec quelques effets secondaires à vérifier. Les container queries adaptent les composants à leur espace sans scripts. De nombreuses autres fonctionnalités natives permettent de supprimer des bibliothèques JavaScript. Ce sont de petites modifications, sûres grâce à l’amélioration progressive, à appliquer là où la page est vraiment volumineuse et à contrôler par des mesures.
