Cher Sean Giuseppe Semeraro, fondateur et administrateur système d’Iweblab Srl, pourriez-vous nous expliquer quelque chose ? Dans le groupe Facebook WordPress Italia, vous avez publié un post intitulé « A voler fare gli sboroni con il PageSpeed a 100 » (en gros : « Frimer avec un score PageSpeed de 100 »), pour dire à tout le monde que de beaux chiffres de TTFB « ne disent presque rien » et que la seule chose qui compte, c’est le vert dans CrUX. Soit. Alors expliquez-nous pourquoi votre site, qui tourne sur votre « Edge network », la solution de cache que vous vendez à vos clients, répond en Europe avec un TTFB 70 % plus lent que le nôtre, à Milan plus de deux fois plus lent, et 26 % plus lent sur la moyenne mondiale ?
Une précision : notre site, managedserver.it, n’utilise aucun CDN, ni propriétaire ni commercial.
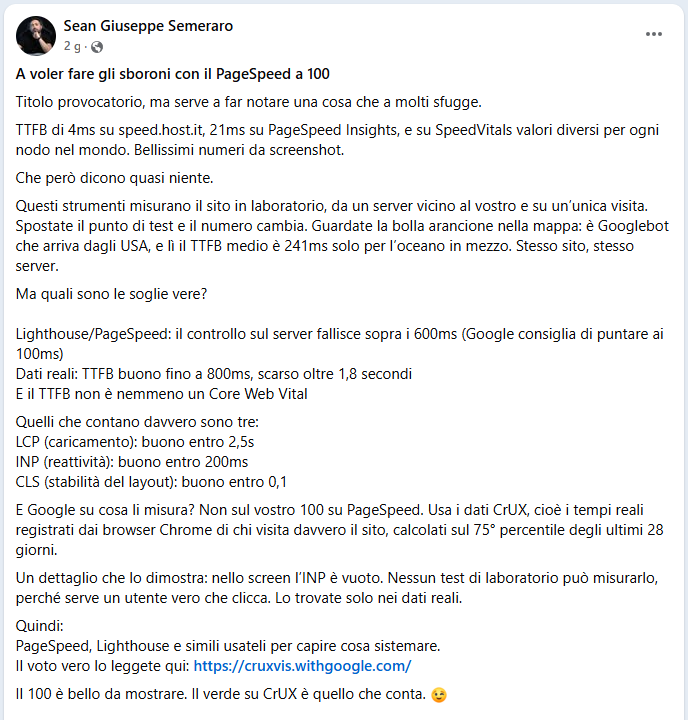
Nous relevons la provocation parce que, au-delà des chiffres, ce post contient une idée fausse très répandue chez les administrateurs système et les développeurs : que la performance d’un site se joue tout entière sur le serveur, et qu’il suffit de regarder une seule source de données, CrUX, pour savoir si un travail a été bien fait. Nous y viendrons. D’abord, les chiffres.
Les chiffres : même outil, même métrique
Le premier rapport est celui que le post lui-même joint : SpeedVitals sur iweblab.sm, le 22 octobre. Le second est managedserver.it, avec le même outil, le 24 octobre.
| TTFB (SpeedVitals) | iweblab.sm, avec « Edge network » | managedserver.it, sans CDN |
|---|---|---|
| Europe | 194 ms | 114 ms |
| Milan | 81 ms | 38 ms |
| Francfort | 86 ms | 71 ms |
| Amériques | 620 ms | 534 ms |
| Moyenne mondiale | 407 ms | 324 ms |
| Taux de succès du cache (cache hit rate) | non détecté | 100 % |
| Note | C | B |
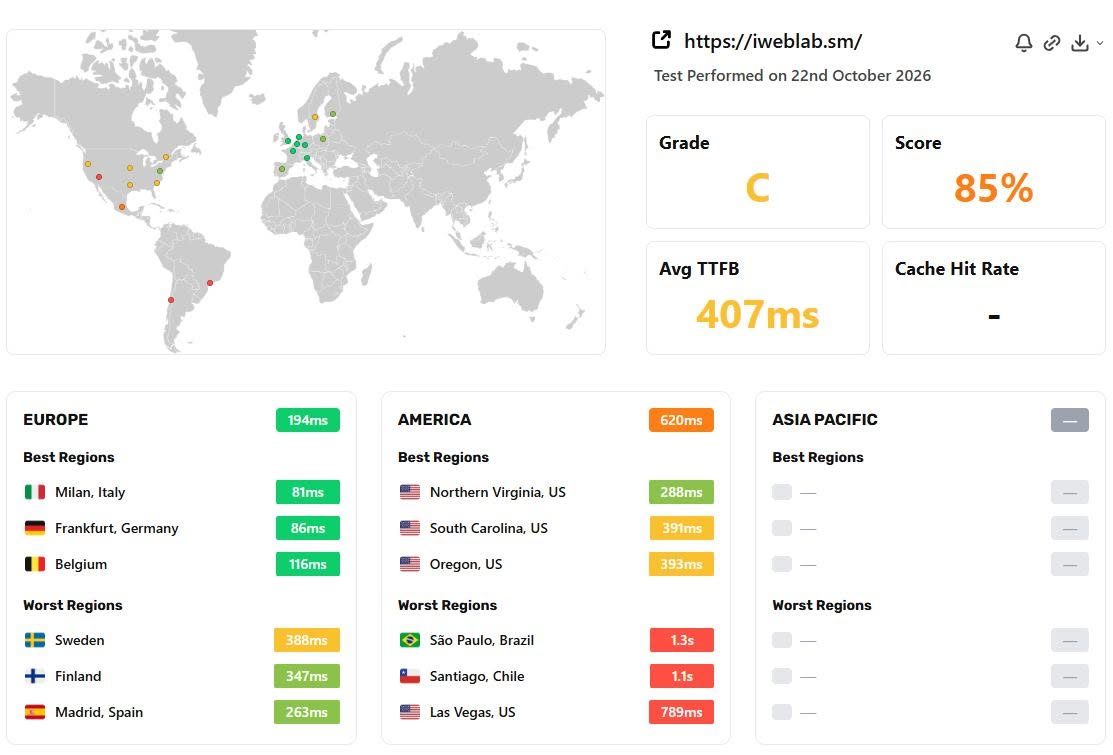
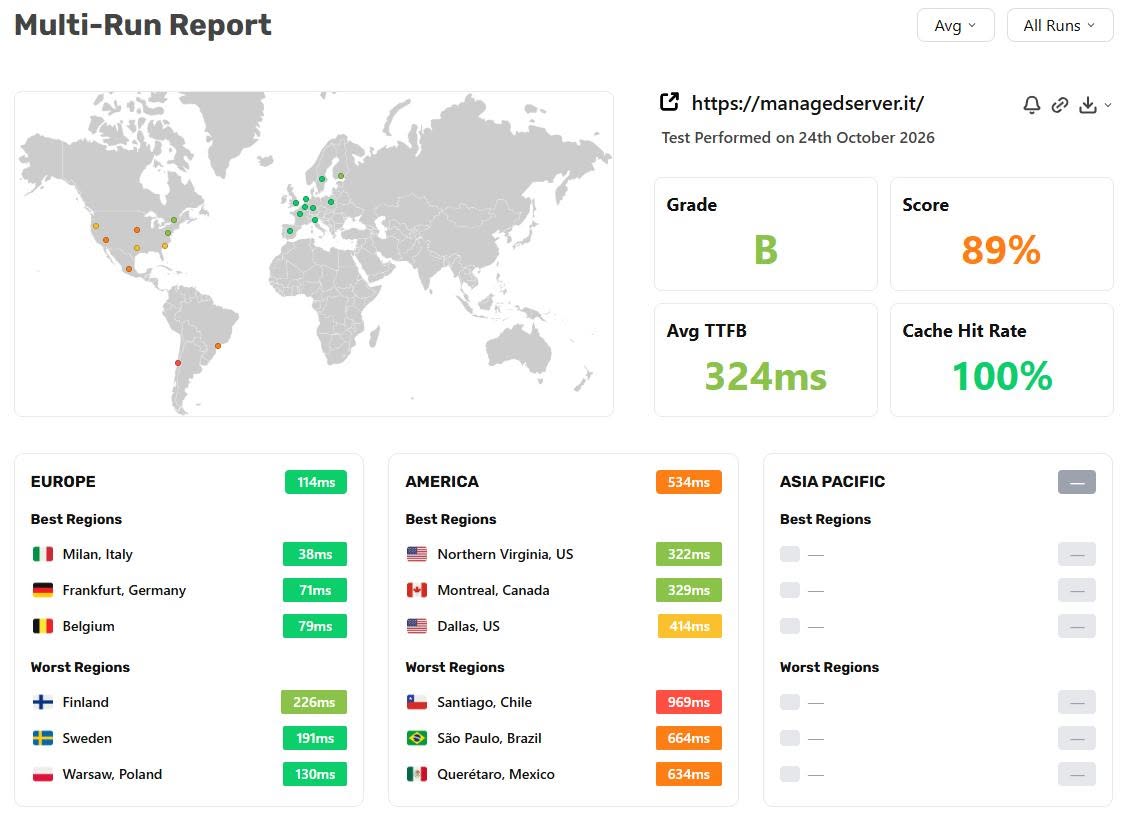
Un site sans CDN qui répond en Europe presque deux fois plus vite qu’un site servi par un réseau qui, sur votre site, « garde les pages en cache sur ses nœuds et les livre depuis un point proche ». Quelque chose ne colle pas. Et ce n’est pas la faute du laboratoire.
Un « Edge network » qui ne livre pas depuis un point proche
Peut-être la raison est-elle que votre CDN maison achemine le trafic avec du GeoDNS au lieu de l’anycast, et ne fonctionne pas comme il le devrait. On le voit dans le test Uptrends : selon l’emplacement, iweblab.sm se résout vers des adresses IP différentes. 95.110.225.107, un réseau Aruba, depuis Milan, Rome, Palerme et même Lille. 81.31.156.7, un réseau enregistré au nom d’Iweblab, depuis Francfort, Salzbourg, Prague, Amsterdam, Leipzig et Eindhoven. 40.160.20.191, un réseau OVH aux États-Unis, depuis Montréal et New York. Avec l’anycast, l’adresse serait la même partout et le réseau choisirait le nœud le plus proche. Ici, c’est le DNS qui décide, avec toutes les limites que cela implique.
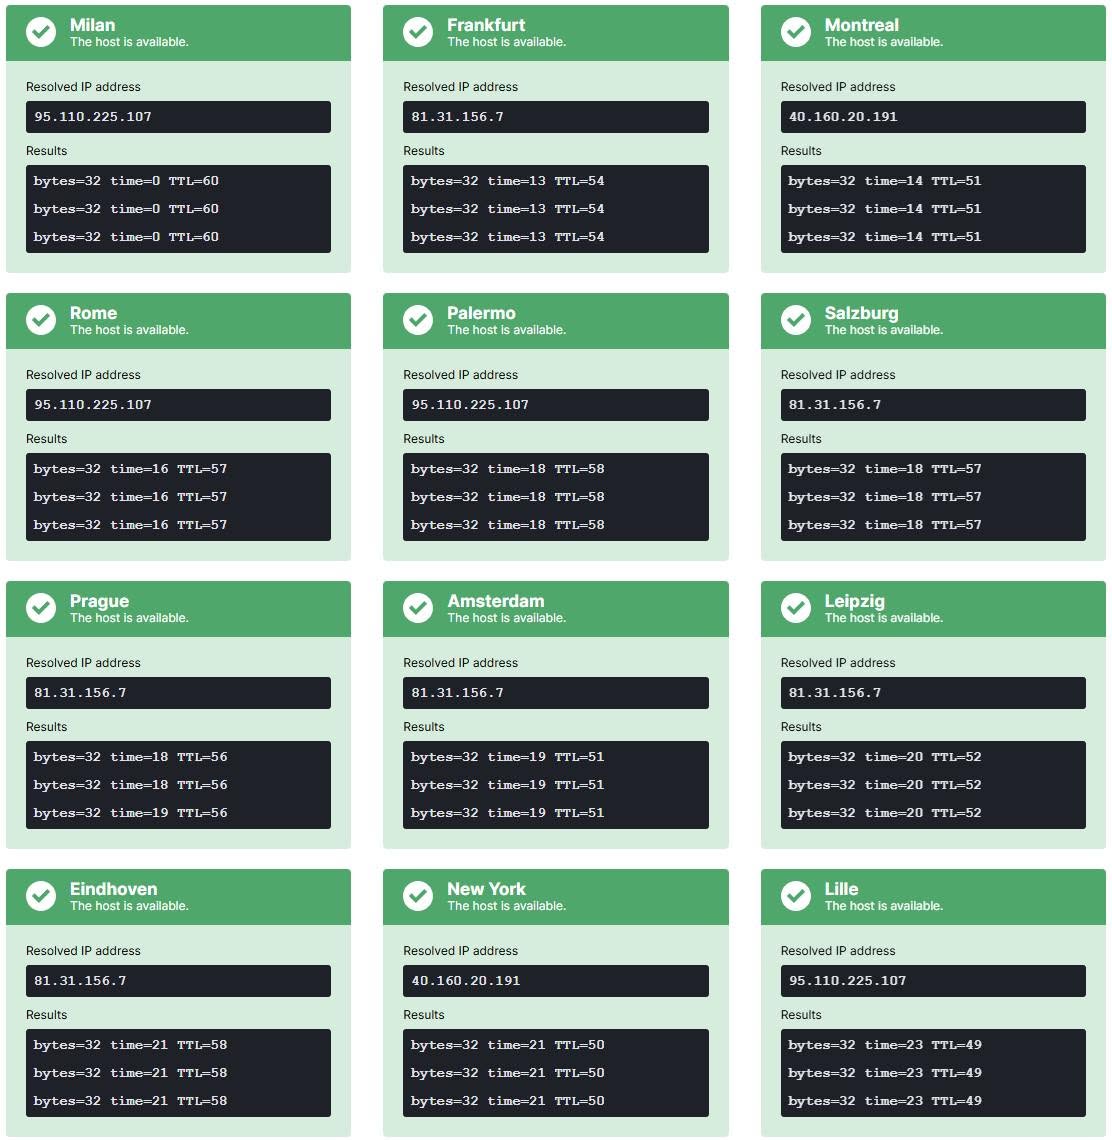
Il y a un détail encore plus parlant. Le ping vers ces nœuds est très bas : 13 ms depuis Francfort, 18 depuis Prague, 21 depuis New York. Pourtant, le TTFB mesuré depuis Francfort est de 86 ms et depuis la Virginie du Nord de 288 ms. Si le réseau met une vingtaine de millisecondes à atteindre le nœud, le reste du temps ne se perd pas dans les câbles : il se perd dans le nœud, ou derrière le nœud, lorsque la page n’est pas en cache et doit être demandée à l’origine.
La confirmation vient de votre propre tableau de bord « Googlebot Map » (la « Mappa Googlebot » de la capture d’écran). 90 % des requêtes de Googlebot passent par le POP de Vint Hill, en Virginie, le même data center OVH vers lequel pointent Montréal et New York. Taux de succès du cache : 58,7 %. TTFB moyen : 241 ms. Dans le post, vous les attribuez « uniquement à l’océan entre les deux ». Mais entre Googlebot, qui arrive des États-Unis, et un POP en Virginie, il n’y a pas d’océan. Il apparaît quand le POP n’a pas la page et doit la demander en Europe : à en juger par ce tableau de bord, environ quatre fois sur dix. L’océan n’est pas une fatalité géographique : c’est le symptôme. La cause, c’est le cache.
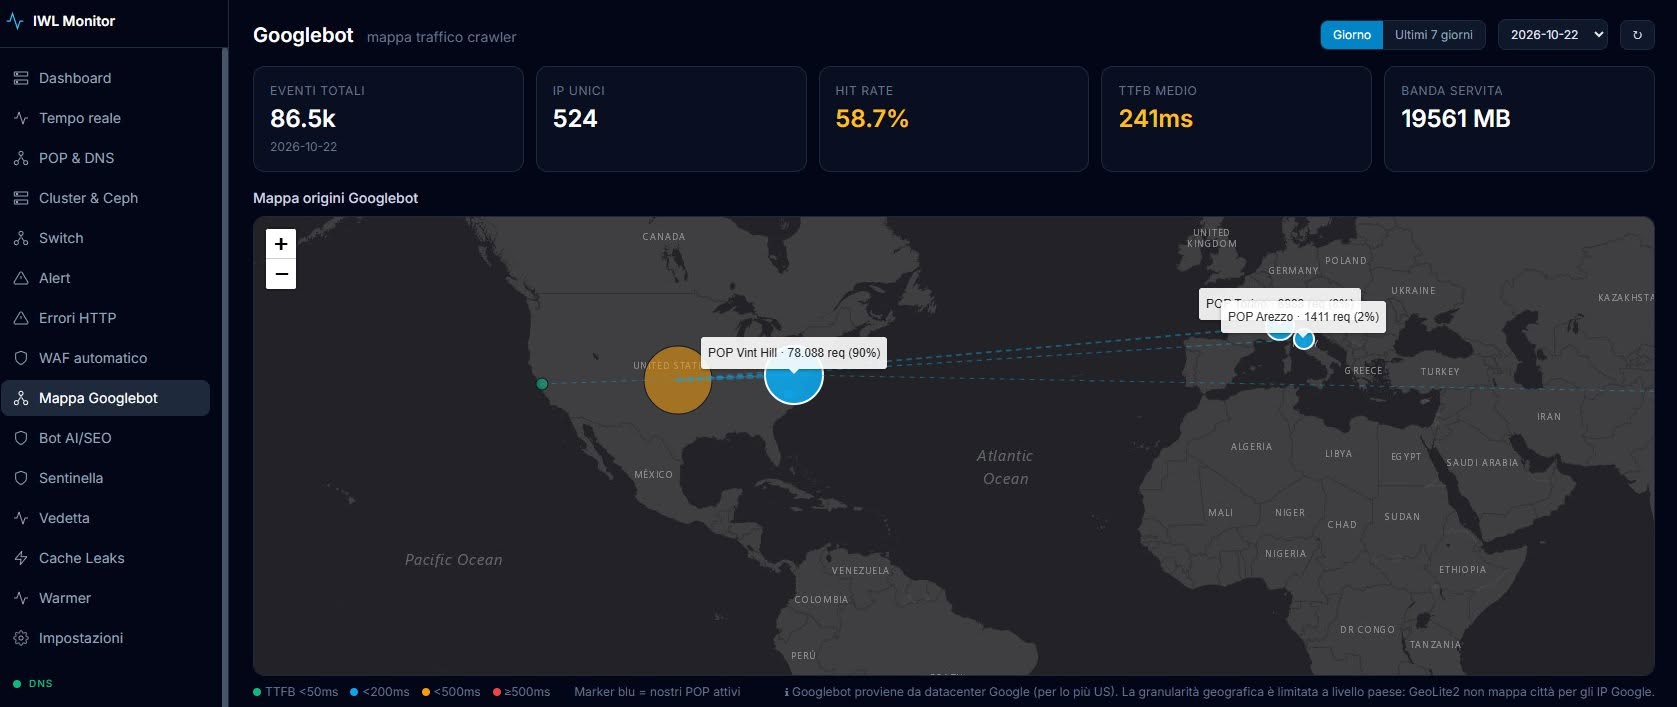
Et ce n’est pas un détail cosmétique : dans la documentation sur le budget de crawl, Google explique que si les temps de réponse d’un site s’allongent, la limite de crawl baisse et Googlebot explore moins de pages. Googlebot n’est pas un utilisateur de Chrome : ici, CrUX ne sauve personne.
Les crevettes tempura
Soyons clairs : nous admirons quiconque essaie de faire des choses, quelles qu’elles soient. Il y a quelques mois, nous avons décidé de faire des crevettes tempura. Nous avons acheté les meilleurs ingrédients, regardé et lu des dizaines de vidéos et de guides, avec un dévouement et une passion entiers. Le résultat ? Immangeable. Ou plutôt : bon pour que nous le mangions à la maison, mais certainement pas pour le servir dans un restaurant, pas même dans le plus modeste des buffets à volonté.
Le problème n’est pas d’essayer. Le problème est que, face à des chiffres comme ceux-ci, on ne dit pas « OK, en fait je ne suis pas prêt, il y a du travail à faire, je retire l’offre publique, je me fais discret pendant un an et je reviens ». Non : on publie un post sur WordPress Italia qui cherche à minimiser, en déformant jusqu’à ce que recommande Google. Voyons comment.
1. « Lighthouse/PageSpeed échoue au-delà de 600 ms »
Exact. Mais vous utilisez un seuil de diagnostic pour justifier une performance qui peut être considérablement améliorée.
Google, dans la documentation officielle de PageSpeed Insights, l’a écrit noir sur blanc : « Vous devriez réduire le temps de réponse du serveur à moins de 200 ms ». Cette page appartient à la version 4 de PageSpeed Insights, aujourd’hui obsolète, et nous le précisons par honnêteté. Mais elle montre que Google a toujours indiqué des objectifs bien plus ambitieux que 600 ms. Les 100 ms que le post attribue à Google, en revanche, n’apparaissent ni là ni dans la documentation de Lighthouse.
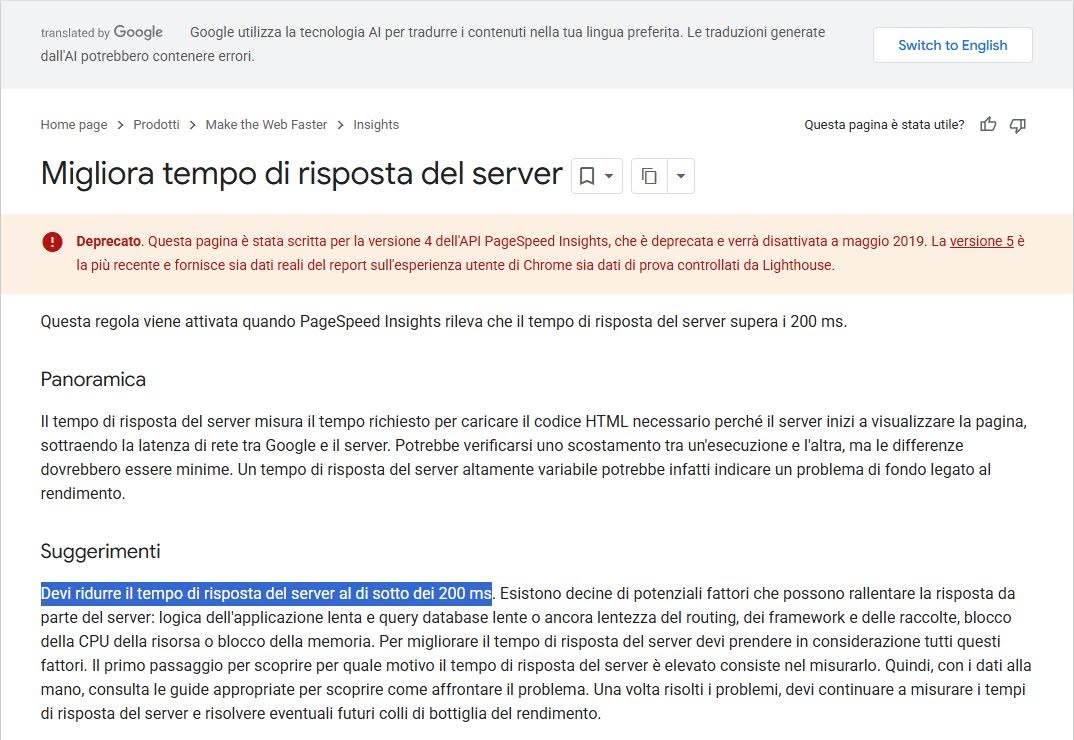
Aujourd’hui, Lighthouse signale le problème au-delà de 600 ms, tandis que les données d’utilisateurs réels classent comme bon un TTFB jusqu’à 800 ms. Mais ce sont trois concepts différents : des recommandations d’optimisation, des seuils de diagnostic et des classifications statistiques de l’expérience réelle. Les confondre, c’est passer à côté de la différence entre obtenir une note suffisante et construire une infrastructure vraiment rapide. Surtout quand on parle de connexions haut débit, de serveurs géographiquement proches et de pages WordPress servies entièrement depuis le cache.
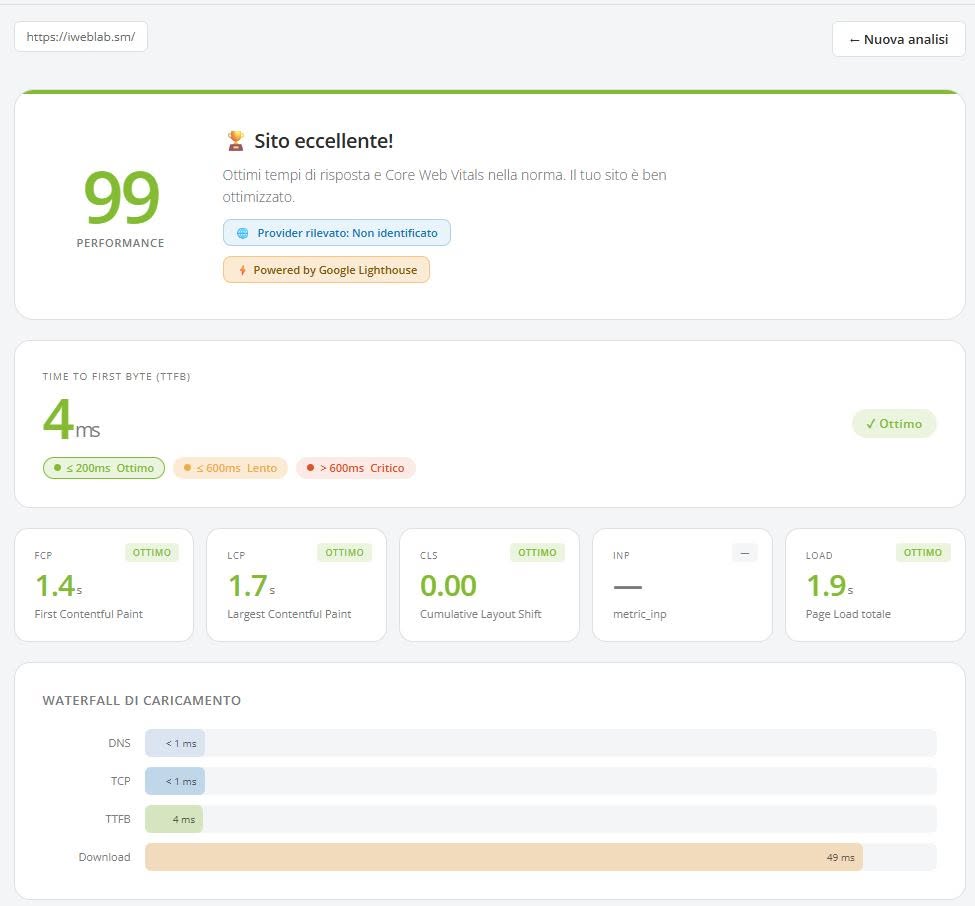
Que Google ne signale aucun problème sous 600 ms ne veut pas du tout dire qu’un TTFB de 500 ms est un excellent résultat. Cela veut seulement dire qu’il n’a pas franchi ce seuil de diagnostic précis. Et la capture d’écran de speed.host.it jointe au post est la preuve par contraste : un seul test de laboratoire, un INP vide, et le verdict « Core Web Vitals dans la norme ».
2. « Le TTFB n’est même pas un Core Web Vital »
C’est peut-être l’affirmation la plus inquiétante. Non parce qu’elle est fausse, mais à cause de ce qu’elle sous-entend.
Le TTFB n’est pas l’un des trois Core Web Vitals officiels, qui sont LCP, INP et CLS. Mais c’est une métrique fondamentale qui précède le FCP et le LCP : chaque milliseconde perdue avant de recevoir le premier octet est une milliseconde de moins pour finir d’afficher la page. Google l’explique lui-même dans son guide sur le TTFB : le TTFB précède les autres métriques de chargement, et le temps qui s’y accumule se répercute sur toutes les suivantes. Se servir du fait qu’il ne soit pas un Core Web Vital pour minimiser son importance, c’est ne pas avoir compris la relation entre les métriques.
Le problème de fond est que le post utilise des seuils statistiques, conçus pour classer l’expérience des utilisateurs, comme s’il s’agissait de certifications de la qualité technique d’un travail. Ce sont deux choses profondément différentes. Un médecin ne vous dit pas que vous êtes un athlète parce que vos valeurs se situent dans les plages normales. De la même façon, un administrateur système ne devrait pas affirmer qu’une infrastructure est particulièrement rapide uniquement parce que PageSpeed Insights affiche un indicateur vert. Et surtout, si l’on vend publiquement des services d’optimisation de la performance, on devrait connaître parfaitement cette différence.
CrUX et LABS : deux outils, deux questions différentes
La conclusion du post est que PageSpeed et Lighthouse servent à « comprendre ce qu’il faut corriger », mais que « la vraie note » est CrUX : « 100, c’est joli à exhiber. Le vert dans CrUX, c’est ce qui compte ». Cela sonne équilibré. En réalité, cela établit une hiérarchie entre les deux sources de données, comme si l’une était la note et l’autre un passe-temps de techniciens. Ce n’est pas le cas : CrUX et les données de laboratoire ne mesurent pas la même chose et ne servent pas au même but. Nous l’expliquons en détail dans Pourquoi il faut à la fois CrUX et LABS ; voici l’essentiel.
CrUX répond à la question « que s’est-il passé ? ». Il collecte les expériences réelles des utilisateurs de Chrome éligibles et évalue le 75e percentile : une métrique est bonne si au moins trois visites sur quatre sont dans le seuil. Mais il couvre une fenêtre glissante de 28 jours, il réagit donc aux changements avec des semaines de retard ; il n’inclut pas Chrome sur iPhone ni les autres navigateurs ; et pour de nombreuses pages, ou pour les sites à faible trafic, les données n’existent tout simplement pas. Surtout, il décrit l’audience que vous avez aujourd’hui. Si neuf visiteurs sur dix naviguent en fibre avec des smartphones récents, une page peut obtenir d’excellentes valeurs même si, en termes absolus, elle est tout sauf légère.
Les données de laboratoire répondent à la question « que pourrait-il se passer, et pourquoi ? ». Elles chargent la page avec un appareil, un réseau et un processeur simulés, dans des conditions contrôlées et reproductibles, et la décomposent : ressources bloquant le rendu, JavaScript excessif, tâches longues sur le thread principal, images surdimensionnées, chaînes de requêtes qui retardent l’élément LCP. Et ce sont les seules qui permettent de comparer l’avant et l’après d’un changement en quelques minutes, au lieu d’attendre un mois. Dire que les données de laboratoire ne comptent pas parce qu’elles sont synthétiques, c’est comme dire qu’un crash test est inutile parce qu’il ne reproduit pas tous les accidents possibles.
Mettre les deux ensemble montre ce qu’aucune des deux ne montre seule : la marge de performance. Deux sites avec le même LCP de 2 secondes dans les données d’utilisateurs réels peuvent être l’un bien construit et l’autre rapide uniquement parce que son audience a des téléphones récents et des réseaux très rapides. Pour CrUX, ils sont identiques. Dès qu’arrive une campagne, un pic de trafic mobile ou un nouveau marché, le premier reste dans les seuils, le second non. Un CrUX vert avec des données de laboratoire faibles n’est pas une promotion : c’est un site avec peu de marge.
Cela fonctionne aussi dans l’autre sens, et c’est là que le post trébuche. Il affirme que l’INP est vide parce qu’« aucun test de laboratoire ne peut le mesurer ». La documentation de Google sur l’INP indique que l’INP peut être mesuré dans certains outils de laboratoire, avec une valeur qui dépend des interactions effectuées pendant la mesure. Dans Lighthouse, il est vide parce que, en mode navigation, il charge la page et ne clique sur rien ; c’est pourquoi Google désigne le Total Blocking Time comme référence de laboratoire. Et dans votre propre capture d’écran de PageSpeed Insights, parmi les audits, figure la ligne « Répartition de l’INP » (« Suddivisione INP »).
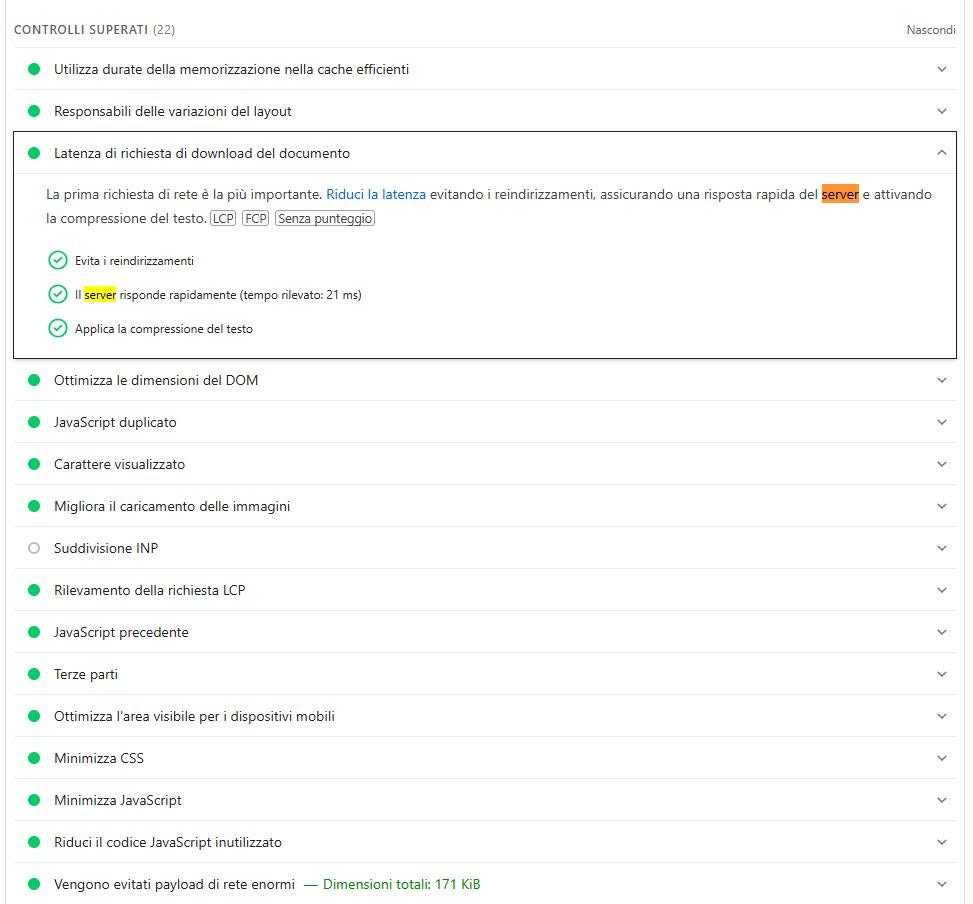
CrUX vous dit qu’il y a un problème. Le laboratoire vous dit lequel, et vérifie immédiatement si la correction fonctionne. Se demander lequel des deux est « la vraie note » est la mauvaise question : remplacer le culte du 100 sur PageSpeed par le culte du vert dans CrUX, c’est changer d’idole, pas de méthode.
Un administrateur système qui fait la leçon sur la performance web
Et maintenant, le point qui, à notre avis, explique tout le reste. Dans tout le post, il n’y a pas un mot sur JavaScript, CSS, le DOM, les images ou les polices. Il parle de TTFB, de seuils et de POP. C’est le périmètre naturel d’un administrateur système : compression Brotli et zstd, HTTP/2 et HTTP/3, TLS, cache, temps de réponse du serveur. Des choses importantes, que nous faisons nous aussi tous les jours. Mais elles sont une partie de la performance, pas la performance.
Les Core Web Vitals se jouent en grande partie dans le navigateur. Le TTFB n’est que la première des quatre phases en lesquelles Google décompose le LCP ; viennent ensuite le délai de chargement et la durée de chargement de la ressource principale, puis le délai de rendu, qui dépendent de la façon dont le HTML, le CSS et les images sont construits. L’INP dépend du JavaScript qui occupe le thread principal quand l’utilisateur touche l’écran. Le CLS dépend de la mise en page, des polices et des contenus insérés tardivement. Un TTFB de 4 ms ne raccourcit pas d’une milliseconde l’exécution de 700 Ko de JavaScript, ne réduit pas un DOM de dix mille nœuds et n’empêche pas une bannière de décaler la page.
C’est pourquoi parler de performance web uniquement du point de vue de l’administrateur système, en s’arrêtant à zstd, Brotli et au TTFB et en laissant de côté toute l’optimisation applicative du DOM, du JavaScript et du CSS, est limitatif. Et quand on le fait pour enseigner aux autres quelles données comptent vraiment, c’est un net dépassement de compétence. La vitesse d’un site vient de l’ensemble : un serveur rapide est le point de départ, une application efficace termine le travail. Celui qui ne connaît que la moitié de la chaîne finit inévitablement par dire que l’autre moitié n’a pas d’importance.
Un sujet difficile, même pour ceux qui le vendent
Cette affaire prouve une seule chose : la performance web est un sujet difficile même pour les professionnels, administrateurs système et développeurs compris. Des seuils de diagnostic pris pour des objectifs, des statistiques prises pour des certifications, un océan incriminé là où il y a des échecs de cache, le laboratoire écarté comme un passe-temps et l’application tout bonnement oubliée. Celui qui doit choisir à qui confier son site devrait exiger des données issues de plusieurs emplacements, des seuils cités à la source, une intervention qui va du serveur au navigateur et une comparaison avant-après honnête. C’est ce que nous faisons. Pas de raccourcis, et pas de tricherie.
Sources : Google, Améliorer le temps de réponse du serveur (PageSpeed Insights v4, obsolète) ; web.dev, Time to First Byte (TTFB) ; Chrome for Developers, Lighthouse : temps de réponse du serveur ; web.dev, Optimiser le Largest Contentful Paint ; web.dev, Interaction to Next Paint (INP) ; Google Search Central, Gérer votre budget de crawl ; iWebLab, iWebLab Cache. La propriété des adresses IP a été vérifiée via whois. Les images d’iweblab.sm sont les captures d’écran jointes au post original et aux tests publics cités, reproduites à des fins de commentaire.
